 AI & Agents·06. September 2026·6 min Lesezeit
Copilot Agents richtig erden
Die Frage klingt harmlos: „Welche Kategorie verursacht die meisten negativen Rückmeldungen?” Ein Agent auf der Feedback-Tabelle beantwortet sie sofort, flüssig und mit Zahlen. Das Problem ist nicht, dass er sich weigert. Das Problem ist, dass er auch dann antwortet, wenn die Rückmeldung, um die es eigentlich geht, in seiner Datengrundlage gar nicht auftaucht.
Grounding — Erdung — wird meist als Sache des Agenten verhandelt: bessere Anweisungen, engere Rolle, ein Satz gegen Halluzinationen. Der wirksamere Teil liegt eine Ebene tiefer. Er entsteht in der Quelle, lange bevor jemand eine Frage stellt.
Dieser Artikel geht das an einer echten Tabelle durch: Kundenfeedback in
Dataverse, vier Datensätze, zwei KI-gestützte Spalten. Alles, was hier steht,
ist in einer Umgebung nachgesehen — keine Doku-Nacherzählung.
Was man zuerst sieht
Die Tabelle hat vier eigene Spalten: Name als Primärspalte, Feedbacktext als
mehrzeiligen Freitext, dazu Kategorie und Sentiment. Dahinter liegen 22
Systemspalten.
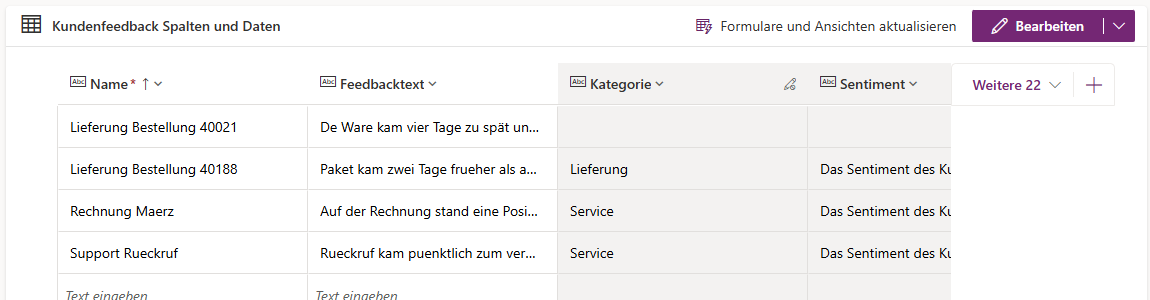
Drei Zeilen tragen eine Kategorie, eine nicht. Und ausgerechnet die leere Zeile ist die interessante:
Lieferung Bestellung 40021
"De Ware kam vier Tage zu spät und der Karton war eingedrückt.
 Der Support hat sich auf zwei E-Mails nicht gemeldet."
Kategorie: —      Sentiment: —
Das ist die einzige eindeutig negative Rückmeldung im Bestand. Für einen Agenten,
der über Kategorie und Sentiment auswertet, existiert sie nicht. Er wird das
nicht sagen. Er wird eine Antwort über die drei anderen geben, und die wird
richtig klingen.
Was technisch wirklich passiert
Kategorie und Sentiment sehen in der Spaltenliste aus wie Textspalten — in
der Spaltendefinition steht etwas anderes:
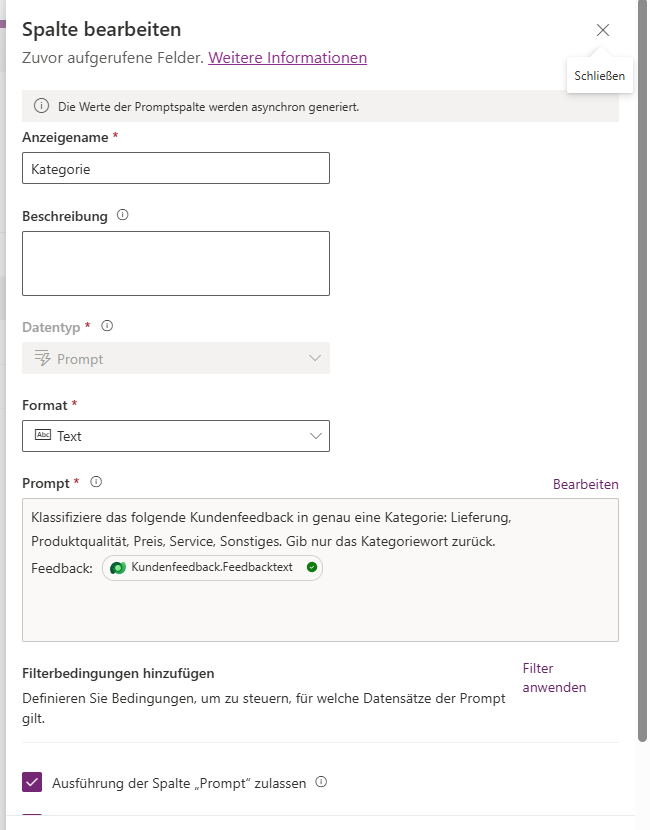
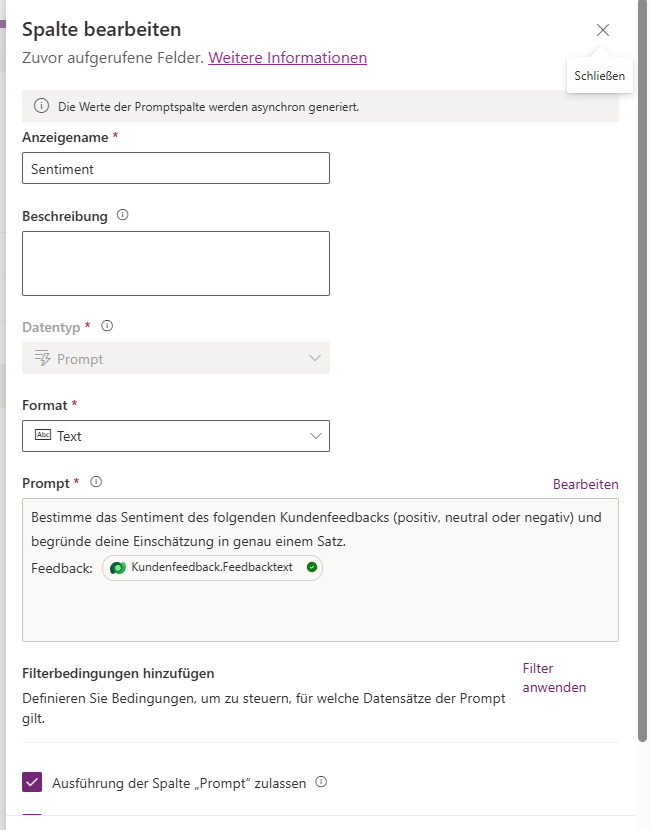
Datentyp Prompt, Format Text. Der Wert entsteht nicht durch Eingabe,
sondern aus einer Anweisung, die an genau eine Eingabespalte gebunden ist:
Klassifiziere das folgende Kundenfeedback in genau eine Kategorie:
Lieferung, Produktqualität, Preis, Service, Sonstiges.
Gib nur das Kategoriewort zurück.

Feedback:  ⟨ Kundenfeedback.Feedbacktext ⟩
Und bei Sentiment:
Bestimme das Sentiment des folgenden Kundenfeedbacks
(positiv, neutral oder negativ) und begründe deine Einschätzung
in genau einem Satz.

Feedback:  ⟨ Kundenfeedback.Feedbacktext ⟩
Damit steht der eigentliche Punkt schon da: Die Struktur, auf die ein Agent sich stützt, entsteht beim Schreiben — nicht beim Antworten. Klassifiziert wird einmal, wenn der Datensatz entsteht oder sich die Eingabespalte ändert. Der Agent liest später nur noch ab.
Der Hinweis oben im Panel ist dabei kein Kleingedrucktes:
Die Werte der Promptspalte werden asynchron generiert.
Wie diese Spalten im Detail funktionieren — Auslöser, Statuscodes, Kosten — steht in Prompt Columns in Dataverse. Hier interessiert nur, was sie für die Erdung eines Agenten bedeuten.
Die naheliegende, aber falsche Abkürzung
„Dann lasse ich den Agenten einfach den Freitext lesen.” Das klingt sparsamer und ist der teurere Weg. Wer den Freitext zur Laufzeit klassifizieren lässt, bekommt bei jeder Frage eine neue Einschätzung — nicht reproduzierbar, nicht filterbar, nicht prüfbar. Zwei gleiche Fragen können zwei verschiedene Zahlen ergeben, und niemand kann hinterher zeigen, woher die eine oder die andere kam. Aggregate über Freitext sind keine Auswertung, sondern eine Schätzung mit Nachkommastellen.
„Dann schreibe ich dem Agenten strengere Anweisungen.” Anweisungen bestimmen den Ton und den Gültigkeitsbereich. Sie bestimmen nicht, was in der Tabelle steht. Gegen eine leere Spalte hilft kein Systemprompt.
Was trägt
Der erlaubte Wortschatz ist die eigentliche Guardrail
Die Rechnungs-Rückmeldung — eine nie bestellte Position auf der Rechnung — steht
in der Tabelle als Service. Nicht als „Rechnung”. Das ist kein Fehler des
Modells, sondern die ehrliche Antwort innerhalb des Wortschatzes, den die Spalte
vorgibt: Lieferung, Produktqualität, Preis, Service, Sonstiges. Eine Kategorie
„Rechnung” gibt es dort nicht.
Daraus folgt eine unbequeme Arbeitsteilung: Wer nach Rechnungsthemen auswerten will, ändert die Spalte, nicht die Frage an den Agenten. Der Wortschatz der Quelle ist die Grenze dessen, was der Agent je unterscheiden kann.
Eine erzwungene Begründung macht die Ableitung prüfbar
Der Sentiment-Prompt verlangt einen Satz Begründung. Das kostet Platz und ist jedes Zeichen wert:
"Das Sentiment des Kundenfeedbacks ist positiv, da trotz eines anfänglichen
 Problems mit einer falschen Position auf der Rechnung die schnelle und
 unkomplizierte Korrektur innerhalb eines Tages hervorgehoben wird."
Man kann über dieses „positiv” streiten — es war immerhin ein Abrechnungsfehler.
Genau deshalb ist die Begründung wertvoll: Sie macht die Bewertung angreifbar.
Ein nacktes positiv hätte niemand hinterfragt.
Der Agent erbt die Rechte des Nutzers
Die Grenze, die am zuverlässigsten hält, ist die, die nicht im Agenten liegt. Ein Agent auf einer Dataverse-Tabelle sieht, was die fragende Person sehen darf — Sicherheitsrollen, Tabellenberechtigungen, Unternehmenseinheiten gelten weiter. Genau deshalb ist es ein Irrweg, Zugriffe über die Identität des Agenten regeln zu wollen; warum, steht in Entra Agent ID.
Ansichten sind die kuratierte Oberfläche
Eine Tabelle mit 26 Spalten ist keine gute Antwortgrundlage. Eine Ansicht, die genau die vier fachlich relevanten Spalten und einen sinnvollen Filter enthält, schon. Was du nicht in die Ansicht nimmst, muss der Agent nicht interpretieren.
Checkliste vor dem ersten Agenten
- Gibt es strukturierte Spalten, oder nur Freitext? Ohne Struktur kann ein Agent nur umformulieren, nicht auswerten.
- Kennst du den Wortschatz? Die Kategorienliste der Spalte ist die Grenze jeder späteren Auswertung. Lies sie, bevor du eine Frage stellst, die sie nicht beantworten kann.
- Sind die Werte vollständig? Datensätze, die vor der Spalte entstanden sind, bleiben leer. Es gibt keinen Nachlauf über den Bestand.
- Prüfst du den Status, nicht nur den Wert? Die Werte entstehen asynchron. Direkt nach dem Speichern ist die Spalte leer — das ist kein Fehler, das ist der Normalfall.
- Erzwingst du eine Begründung? Eine Einstufung ohne Begründung ist nicht überprüfbar.
- Stimmen die Rechte? Der Agent zeigt, was die fragende Person sehen darf. Teste mit einem Konto ohne Adminrechte, nicht mit deinem.
- Ist der Schalter überhaupt an? In der Spaltendefinition steckt „Ausführung der Spalte ‚Prompt’ zulassen”. Steht er aus, bleibt alles leer, ohne Fehlermeldung.
Was unbequem bleibt
Kein Nachlauf über den Bestand. Die älteste Zeile in meiner Tabelle hat weder Kategorie noch Sentiment und wird sie auch nicht bekommen, solange ihr Feedbacktext unverändert bleibt. Wer eine solche Spalte nachträglich einführt, hat einen blinden Fleck über alle Altdaten — und der Agent sagt kein Wort darüber.
Der Wert spiegelt den Eingabestand des Laufs. Ich habe eine Zeile angelegt, deren Feedbacktext zu diesem Zeitpunkt noch leer war. Die Spalte bewertete folgerichtig „keine inhaltlichen Aussagen … daher neutral”. Nachdem der Text nachgetragen war, stand diese Einschätzung noch eine Weile so da, bevor der Nachlauf sie korrigierte. Wer in dem Fenster fragt, bekommt eine saubere, begründete, veraltete Antwort.
Generativ heißt nicht deterministisch. Dieselbe Rückmeldung kann bei einem erneuten Lauf anders eingestuft werden. Für eine Trendauswertung reicht das. Für eine Kennzahl, an der eine Eskalation hängt, nicht.
Struktur ist Arbeit, die jemand pflegen muss. Der Wortschatz veraltet, neue Themen tauchen auf, die Kategorienliste wird zum Wartungsposten. Das ist der ehrliche Preis dafür, dass die Antworten überprüfbar bleiben.
Siehe auch
- Prompt Columns in Dataverse — wie die Spalten funktionieren, die hier die Struktur erzeugen.
- Entra Agent ID — warum Identität keine Berechtigung ist.
- UI-Komponenten im Chat — wenn der Agent nicht nur antwortet, sondern etwas anbietet: derselbe Grundsatz, ein Schritt weiter.