 AI & Agents·23. August 2026·10 min Lesezeit
Ein Gedächtnis, das bleibt: OpenViking als persönliches RAG — von jedem Gerät
Du kennst das: Ein neuer Chat, und die KI weiß wieder nichts. Nicht, wie ihr letzte Woche ein Problem gelöst habt. Nicht, welche Server-Typen bei eurem Hoster nicht mehr existieren. Nicht, welche Konvention ihr euch mühsam erarbeitet habt. Jede Session beginnt bei null — und das mühsam aufgebaute Wissen liegt verstreut in Chatverläufen, die niemand wiederfindet.
Der übliche Reflex: alles in ein Tool packen und hoffen, dass dessen eingebautes „Memory” reicht. Das bindet dein Gedächtnis aber an genau diesen Anbieter und genau dieses Gerät. Wechselst du vom Terminal in den Browser oder aufs Handy, ist es weg.
Die sauberere Idee: Das Gedächtnis ist eine eigene Schicht — unter allen Agenten, nicht in einem von ihnen. Genau das ist OpenViking: eine semantische Langzeitgedächtnis-Datenbank, die als persönliches RAG auf einer kleinen eigenen VM läuft und aus jedem Client erreichbar ist. Dieser Beitrag zeigt das Tool, die Infrastruktur dahinter und warum sich das lohnt — high-level, mit Grafiken und drei echten Demos von drei Geräten.
Was OpenViking ist — und was nicht
Die häufigste Verwechslung zuerst: OpenViking ist keine Alternative zu Claude Code, Cursor oder ChatGPT. Es steht nicht neben deinem Agenten, sondern darunter.
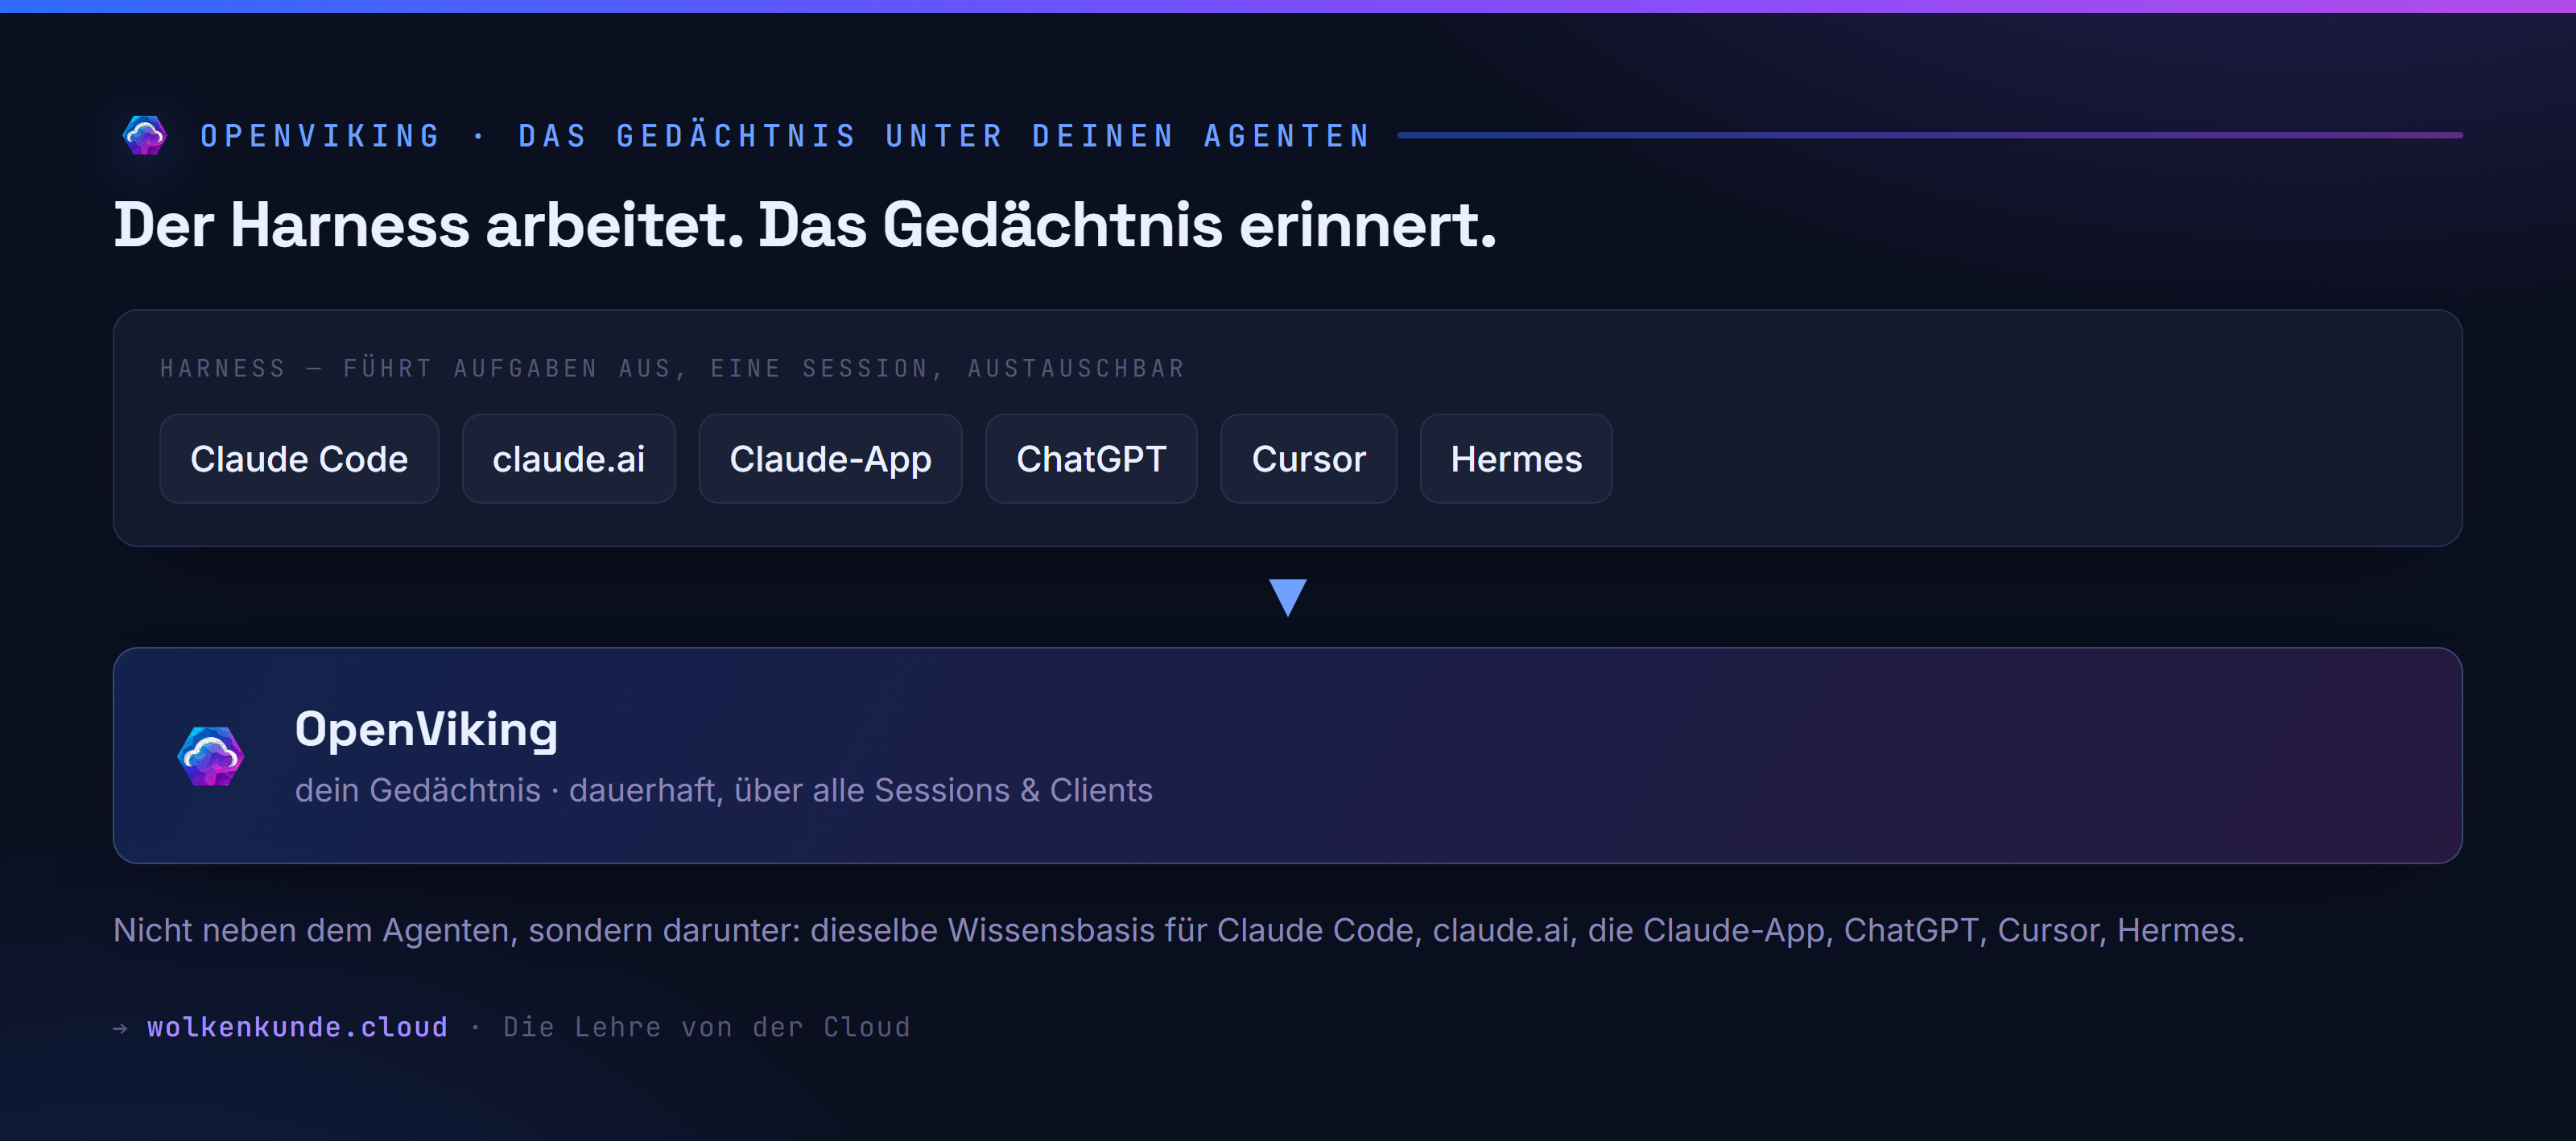
Der Harness — Claude Code, Hermes, Cursor, die Claude-App — führt Aufgaben aus, ruft Werkzeuge auf und ist nach der Session vergessen. Er ist bewusst austauschbar. Das Gedächtnis dagegen soll bleiben: dauerhaft, über alle Sessions, unabhängig davon, mit welchem Werkzeug du gerade arbeitest.
Der praktische Nutzen dieser Trennung: Deine Wissensbasis ist nicht an einen Agenten gebunden. Wer heute im Terminal mit Claude Code arbeitet und morgen zusätzlich Cursor oder die Claude-App am Handy nutzt, greift auf denselben Bestand zu. Ein Beispiel aus der Praxis: Hermes Agent von Nous Research bindet OpenViking direkt als Memory-Provider ein (hermes memory setup openviking), Claude Code über ein kleines Plugin — dieselbe Basis, zwei Werkzeuge.
Individuelles RAG: ein Dateisystem, kein Vektortopf
Jetzt zum Kern — warum das ein gutes persönliches RAG ist und nicht nur „noch eine Vektordatenbank”.
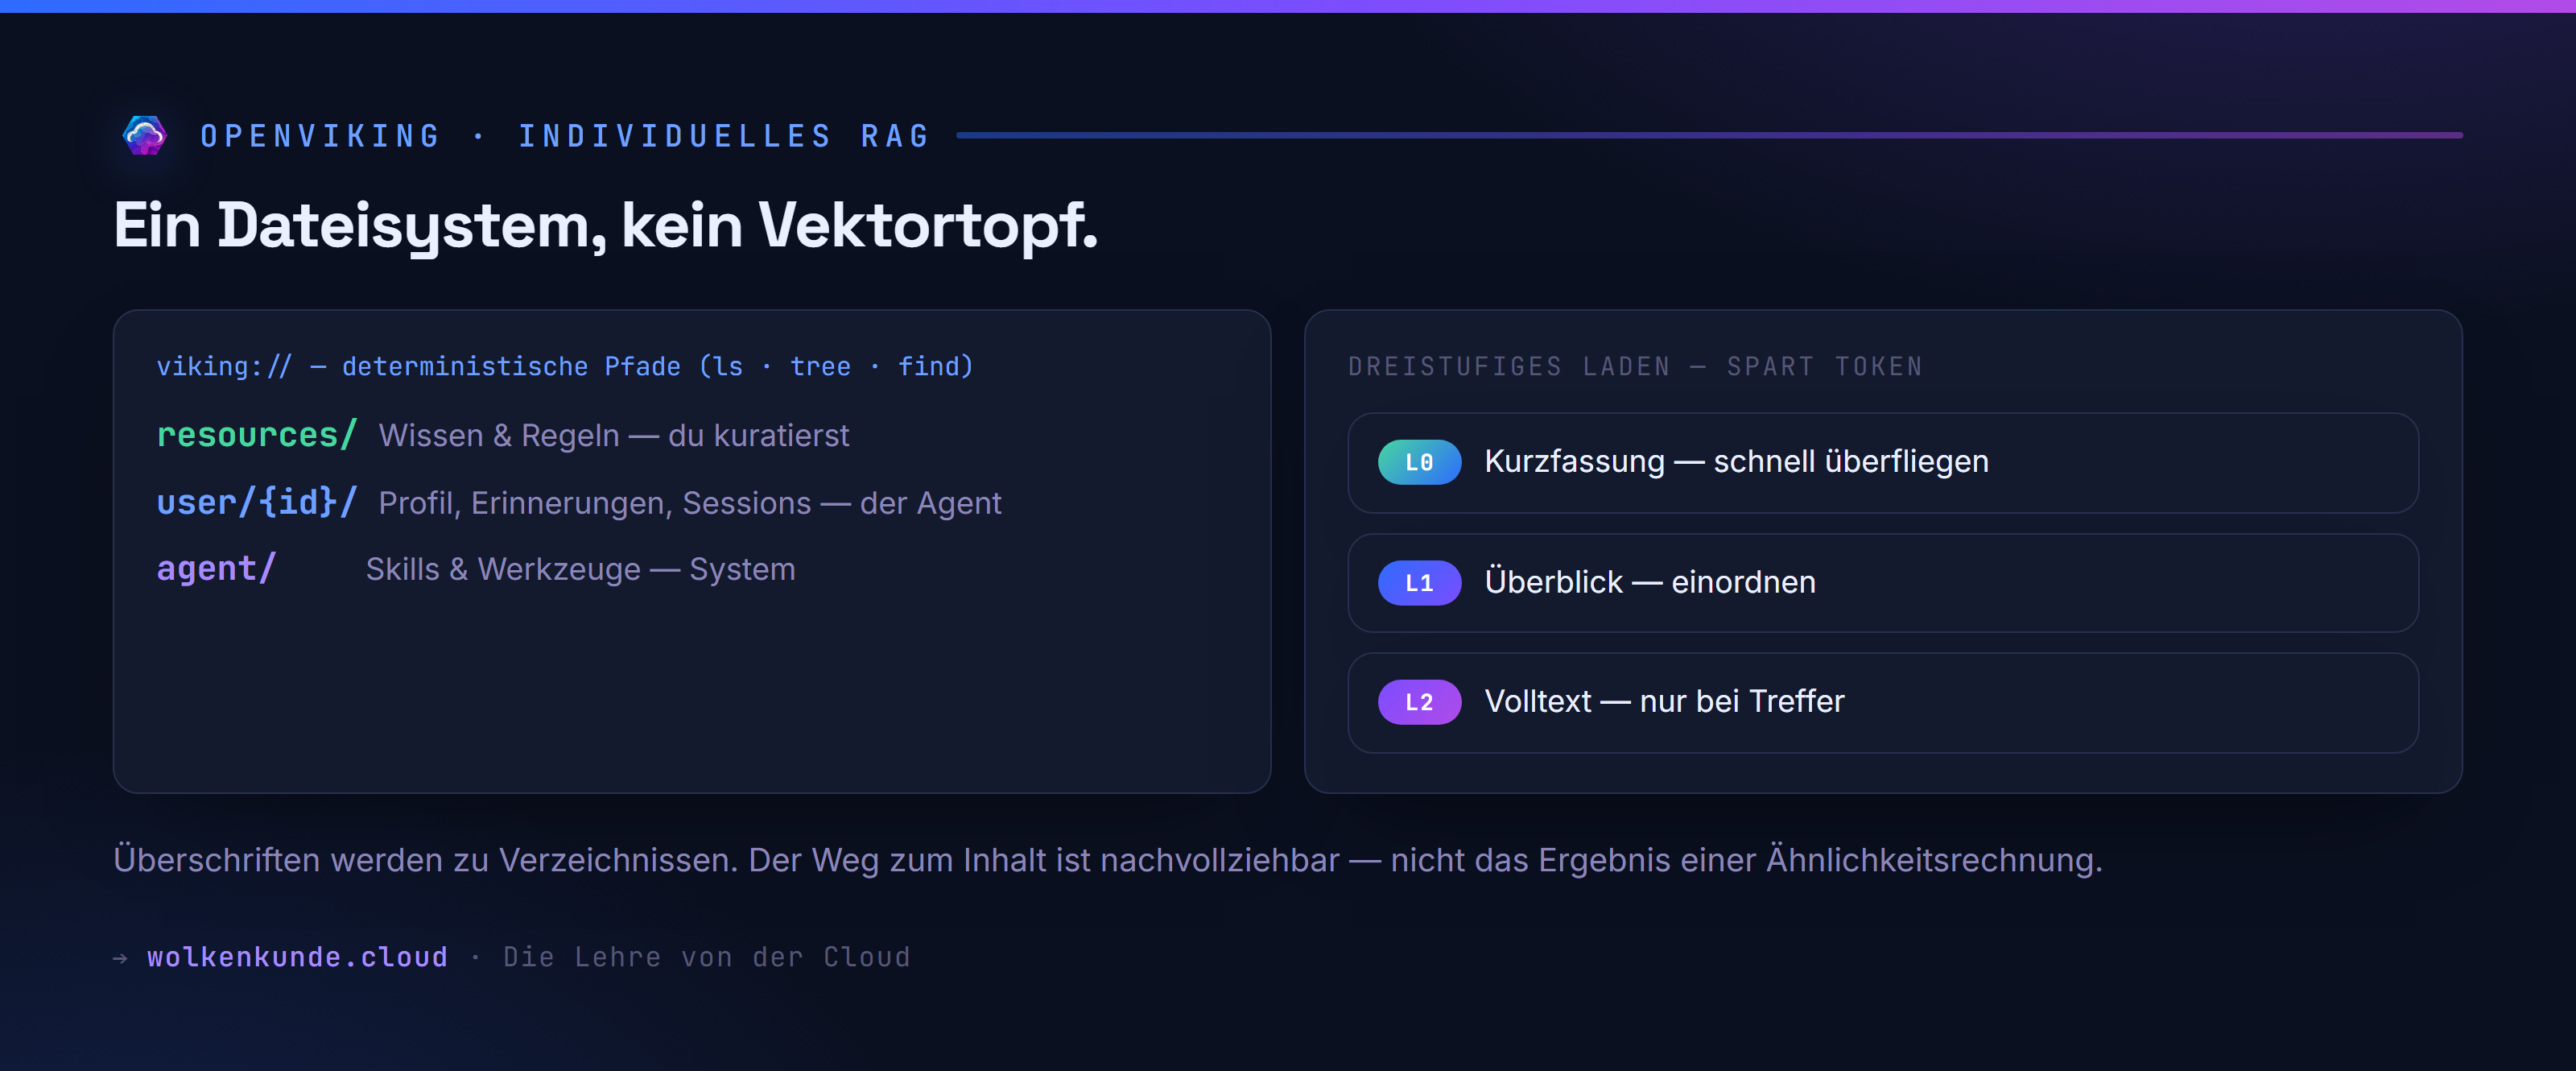
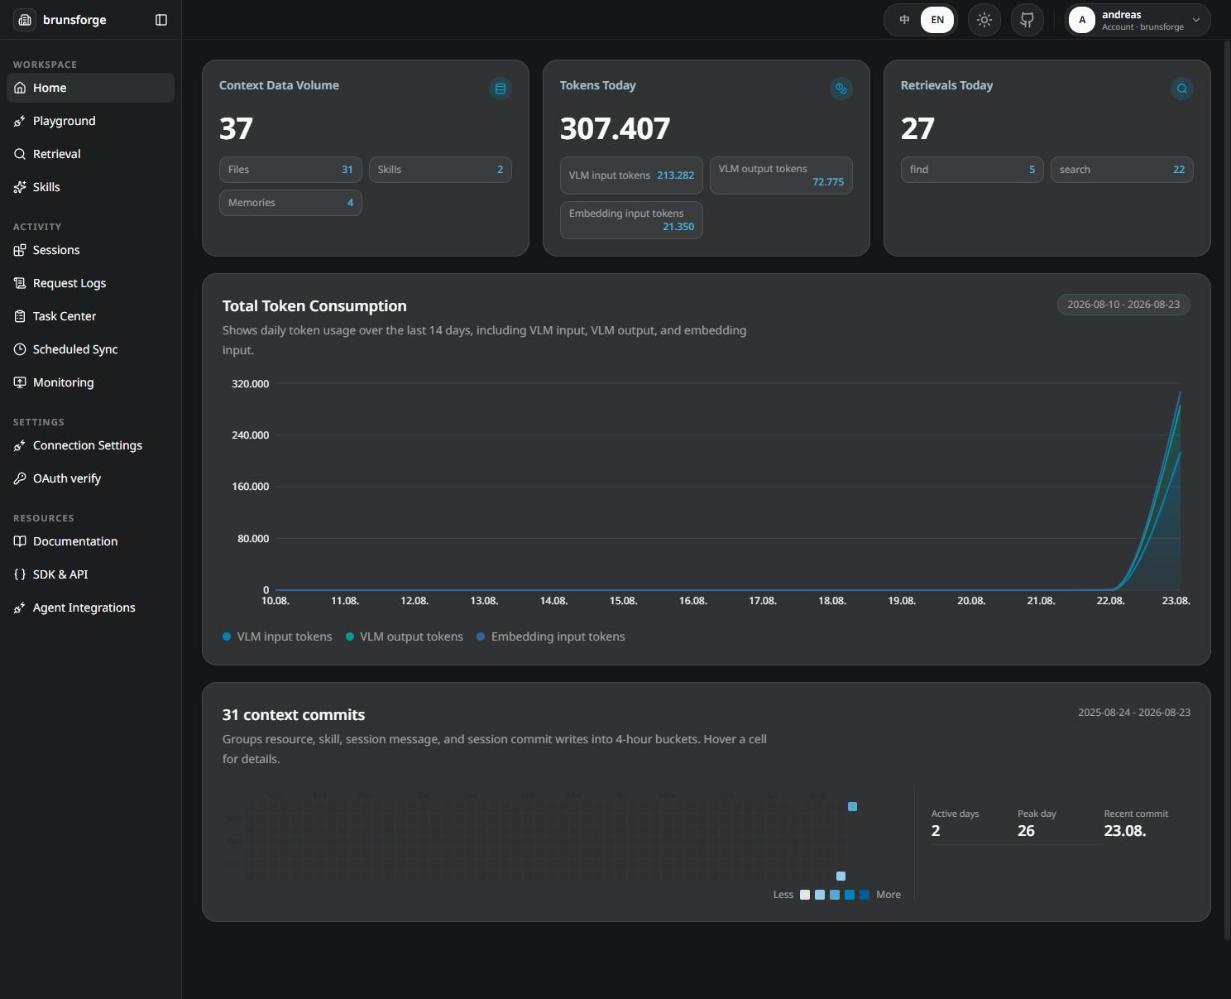
OpenViking bildet allen Kontext als virtuelles Dateisystem unter viking:// ab. Agenten finden Inhalte nicht nur über Vektorsuche, sondern navigieren über deterministische Pfade — mit ls, tree, find. Das ist der wesentliche Unterschied zu einer klassischen Vektordatenbank: Der Weg zu einem Inhalt ist nachvollziehbar und wiederholbar, nicht das Ergebnis einer Ähnlichkeitsrechnung.
Drei feste Bereiche gibt es:
viking://resources/— Wissen und Regeln, die du kuratierst (Dokumentation, Handbücher, Learnings)viking://user/{id}/— Profil, Erinnerungen, Präferenzen, Sessions, die der Agent pflegtviking://agent/— Skills und Werkzeugkonfiguration, vom System verwaltet
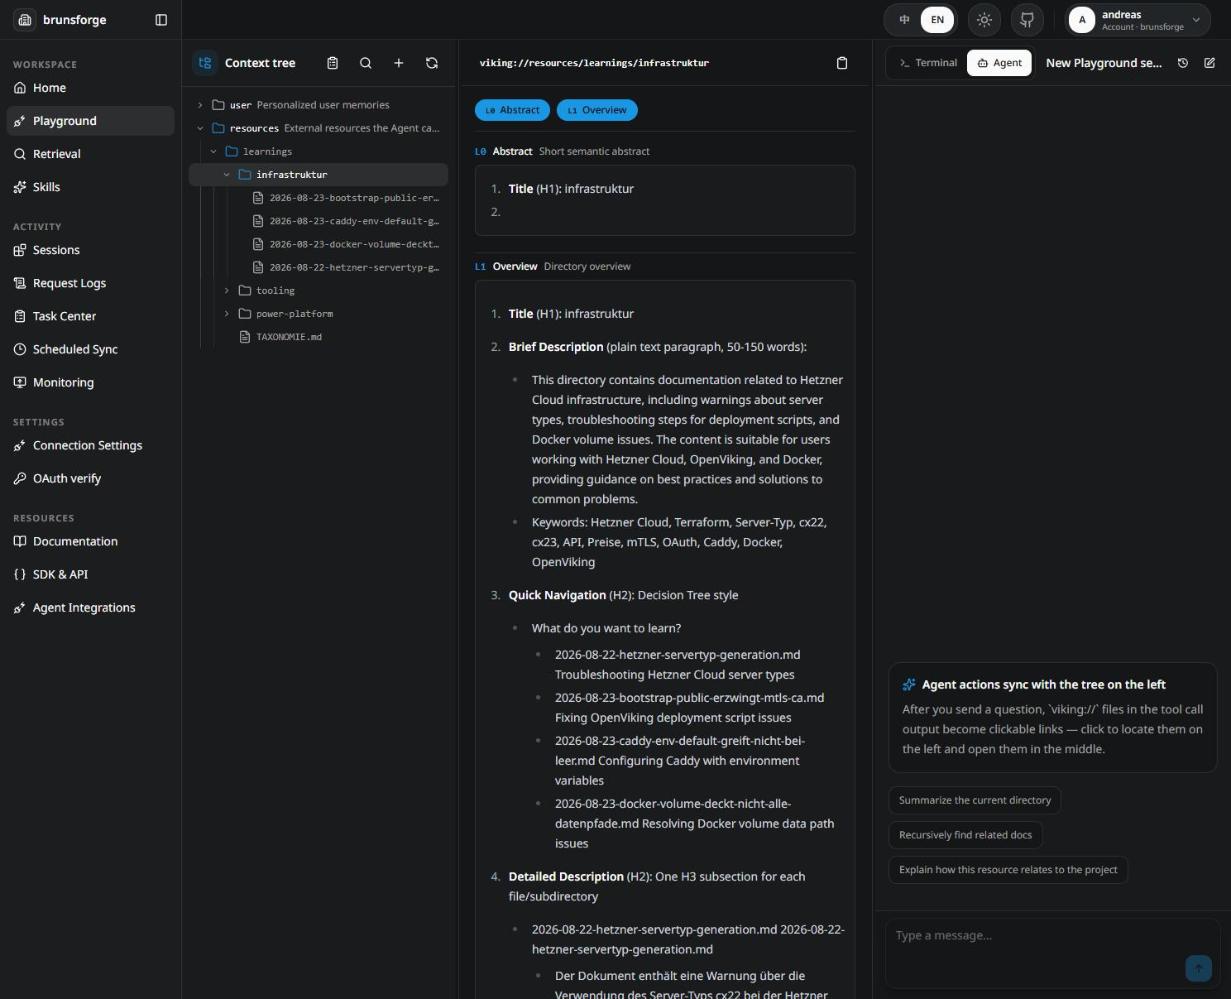
Fügst du ein Dokument hinzu, läuft eine dreistufige Verarbeitung: zerlegen (nach Überschriften, ohne LLM), verdichten (je Datei zwei Kurzebenen per LLM) und indizieren (Vektorindex). Daraus entsteht das token-sparende Laden: Ein Agent liest erst die L0-Kurzfassung, steigt bei Bedarf auf den L1-Überblick und holt den L2-Volltext nur bei echten Treffern. Und weil deine Überschriftenstruktur zur Verzeichnisstruktur wird, bekommt man für sauberes Gliedern eine saubere Ablage geschenkt.
Kuratierte Bibliothek statt Gesprächsmitschnitt
Ein bewusster Unterschied zur Standardnutzung: OpenViking wird oft als automatisches Session-Gedächtnis betrieben — der Harness schreibt alles mit, das System extrahiert daraus Präferenzen. Hier läuft es umgekehrt, als kuratierte Bibliothek: AUTO_CAPTURE ist aus, AUTO_RECALL ist an. Was hineinkommt, sind belegte Mechanismen als Markdown-Dateien mit Diff-Review — kein Gesprächsrauschen.
Der Grund ist einfach: Lesen ist folgenlos, Schreiben wirkt dauerhaft auf alle Projekte. Der automatische Weg füllt die Basis mit Rauschen und trägt Kundennamen hinein, die dort nicht hingehören. Der Diff eines Pull Requests ist die einzige Stelle, an der so etwas noch auffällt, bevor es zentral gespeichert wird.
Die Infrastruktur — high-level
Und worauf läuft das? Bewusst schlank: eine kleine VM, ein Docker-Verbund, eine eigene Datenplatte.
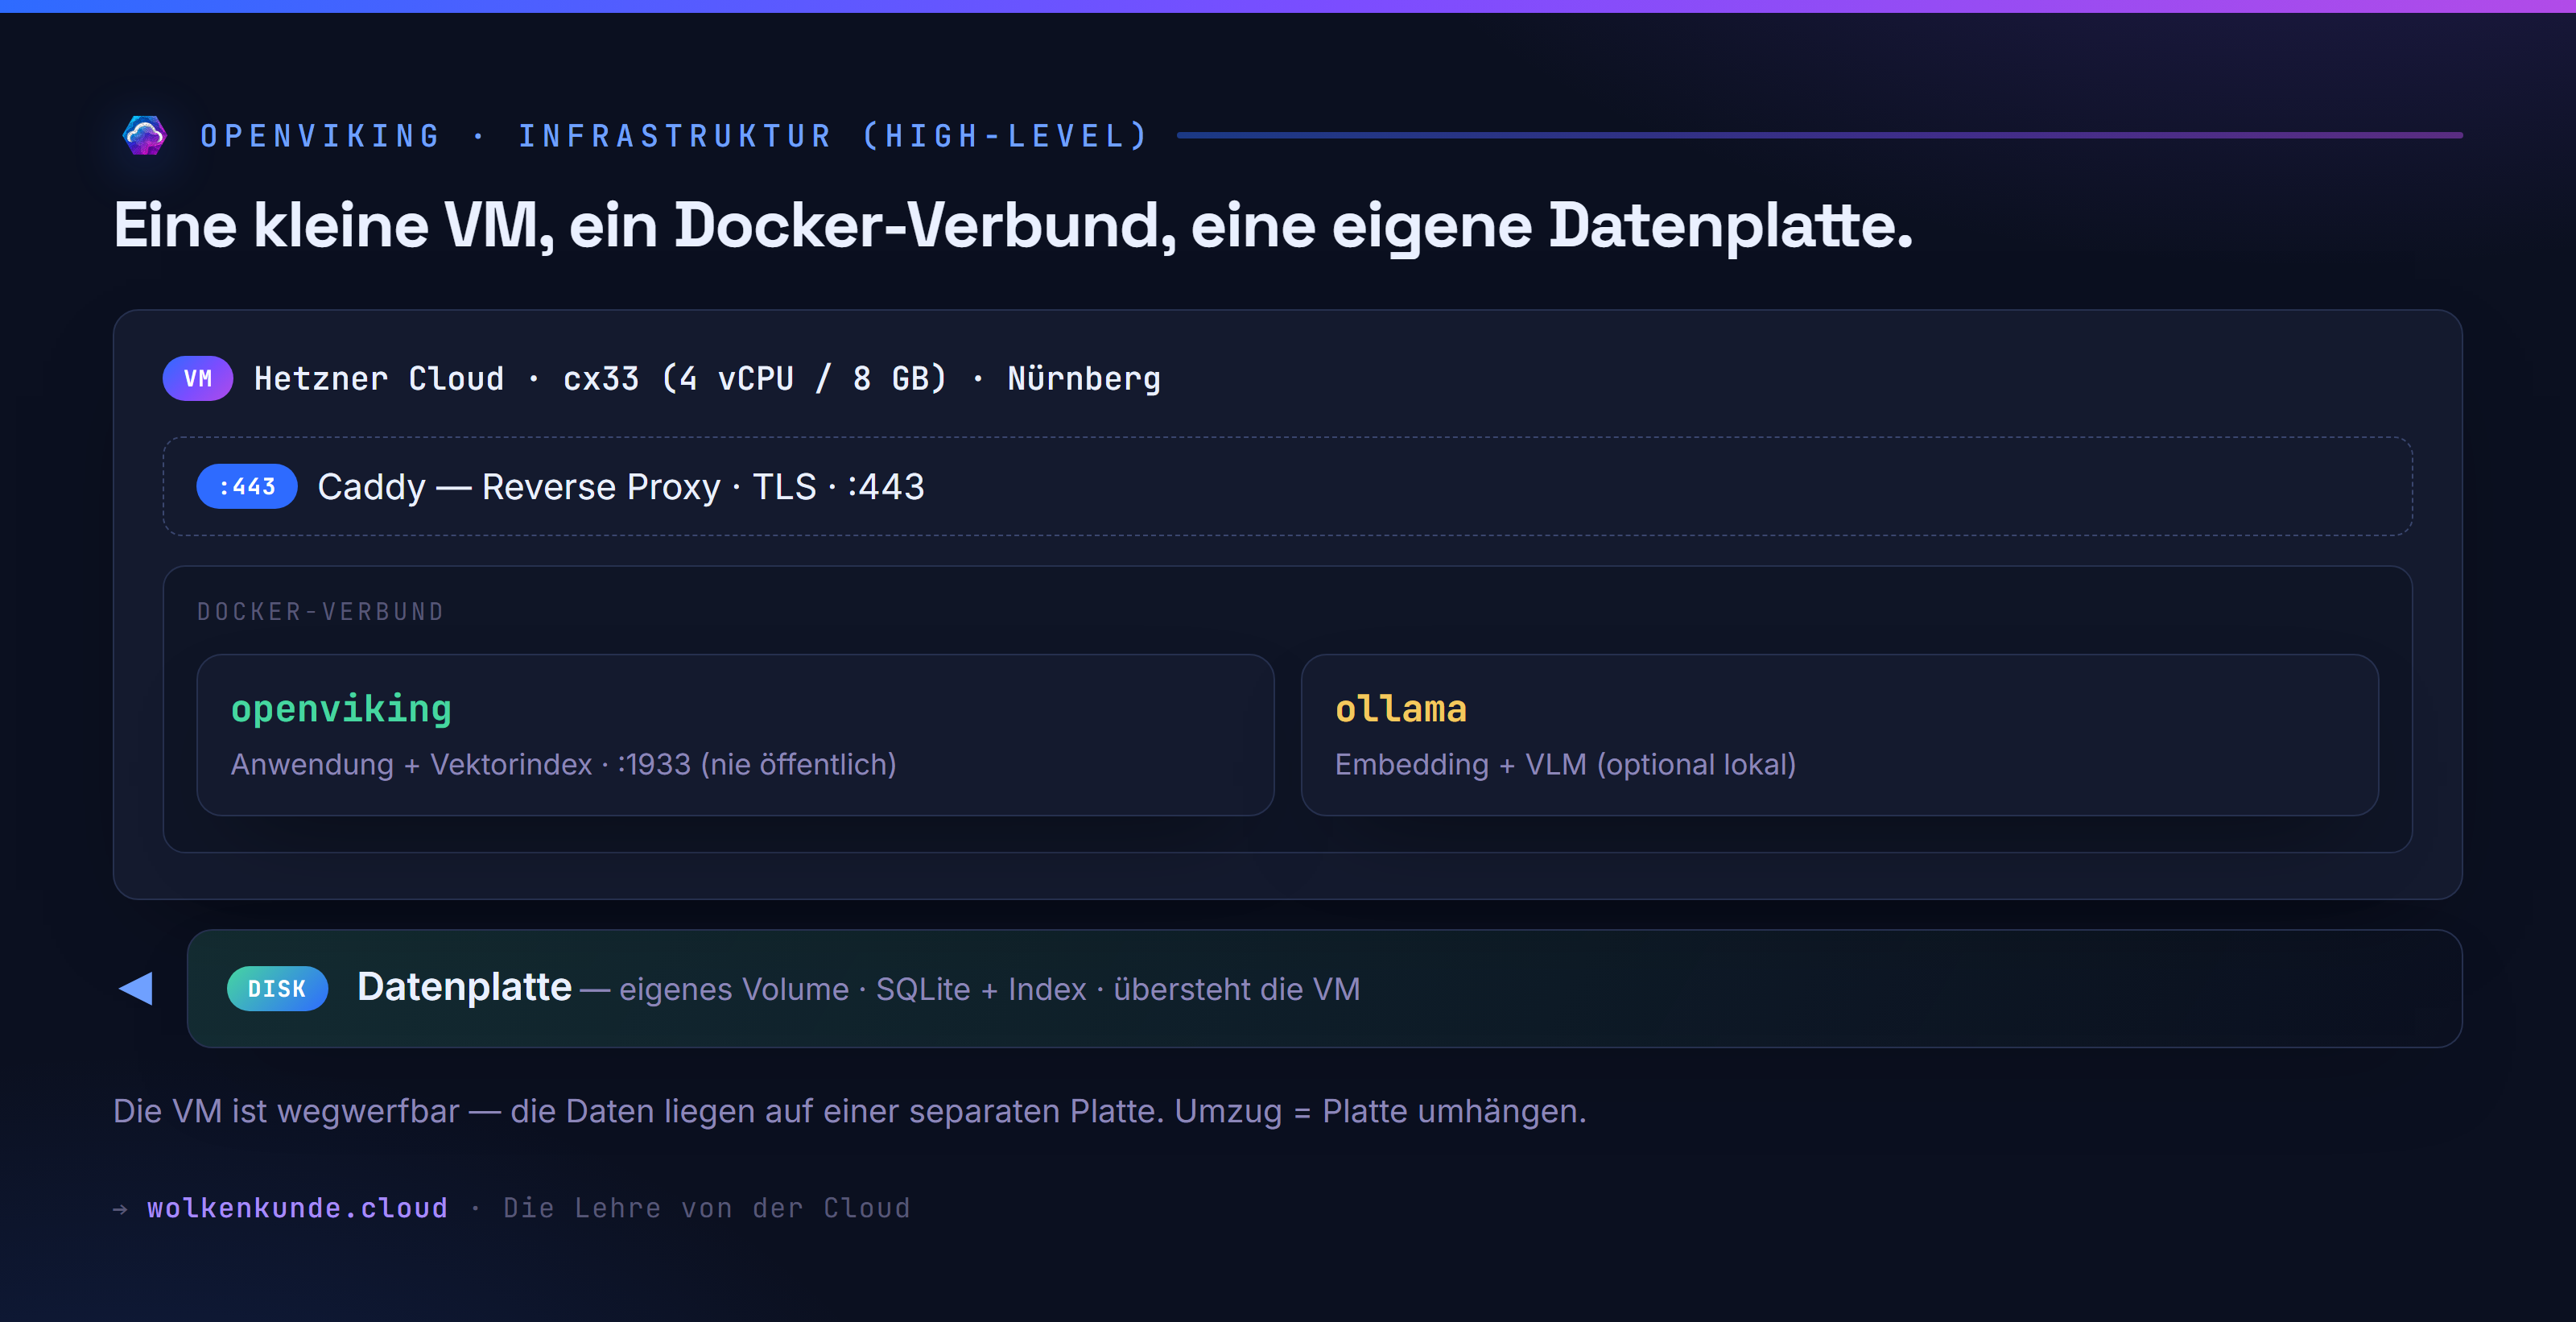
Die Bausteine:
- VM: ein Hetzner-
cx33(4 vCPU, 8 GB) in Nürnberg, per Terraform bereitgestellt. Klein, günstig, ausreichend. - Container:
openviking(die Anwendung samt Vektorindex, Port 1933), optionalopenviking-ollama(Embedding und Vision-Modell, wenn Inhalte lokal bleiben sollen) undopenviking-caddy(Reverse Proxy, TLS, Ports 80/443). - Datenplatte: ein eigenes Volume mit der SQLite-Datenbank und dem Index.
Die letzte Entscheidung ist die wichtigste: Die VM ist wegwerfbar, die Daten liegen getrennt. Kaputtes Update, verkonfigurierter Docker, Ubuntu-Upgrade schiefgelaufen? VM neu bauen, Datenplatte wieder anhängen, fertig. Das ist zugleich der Umzugsweg — auch zu einem anderen Anbieter. Ohne diese Trennung wäre jedes VM-Problem ein Datenproblem, und der Verlust wäre der Verlust von Jahren an Erkenntnissen.
Zwei bewusste Nicht-Entscheidungen der Ehrlichkeit halber: Kein Kubernetes — ein einzelner Container braucht keinen Cluster. Und kein Serverless (Azure Container Apps): Deren Wirtschaftlichkeit kommt aus „Scale-to-zero”, und genau das kann eine Wissensbasis mit persistentem Index nicht — sie müsste dauerhaft laufen und würde bei jedem Prompt kalt starten.
Von jedem Gerät erreichbar — drei Wege
Das eigentliche Versprechen: von überall. Das ist kein Zufall, sondern drei bewusst getrennte Zugangswege.
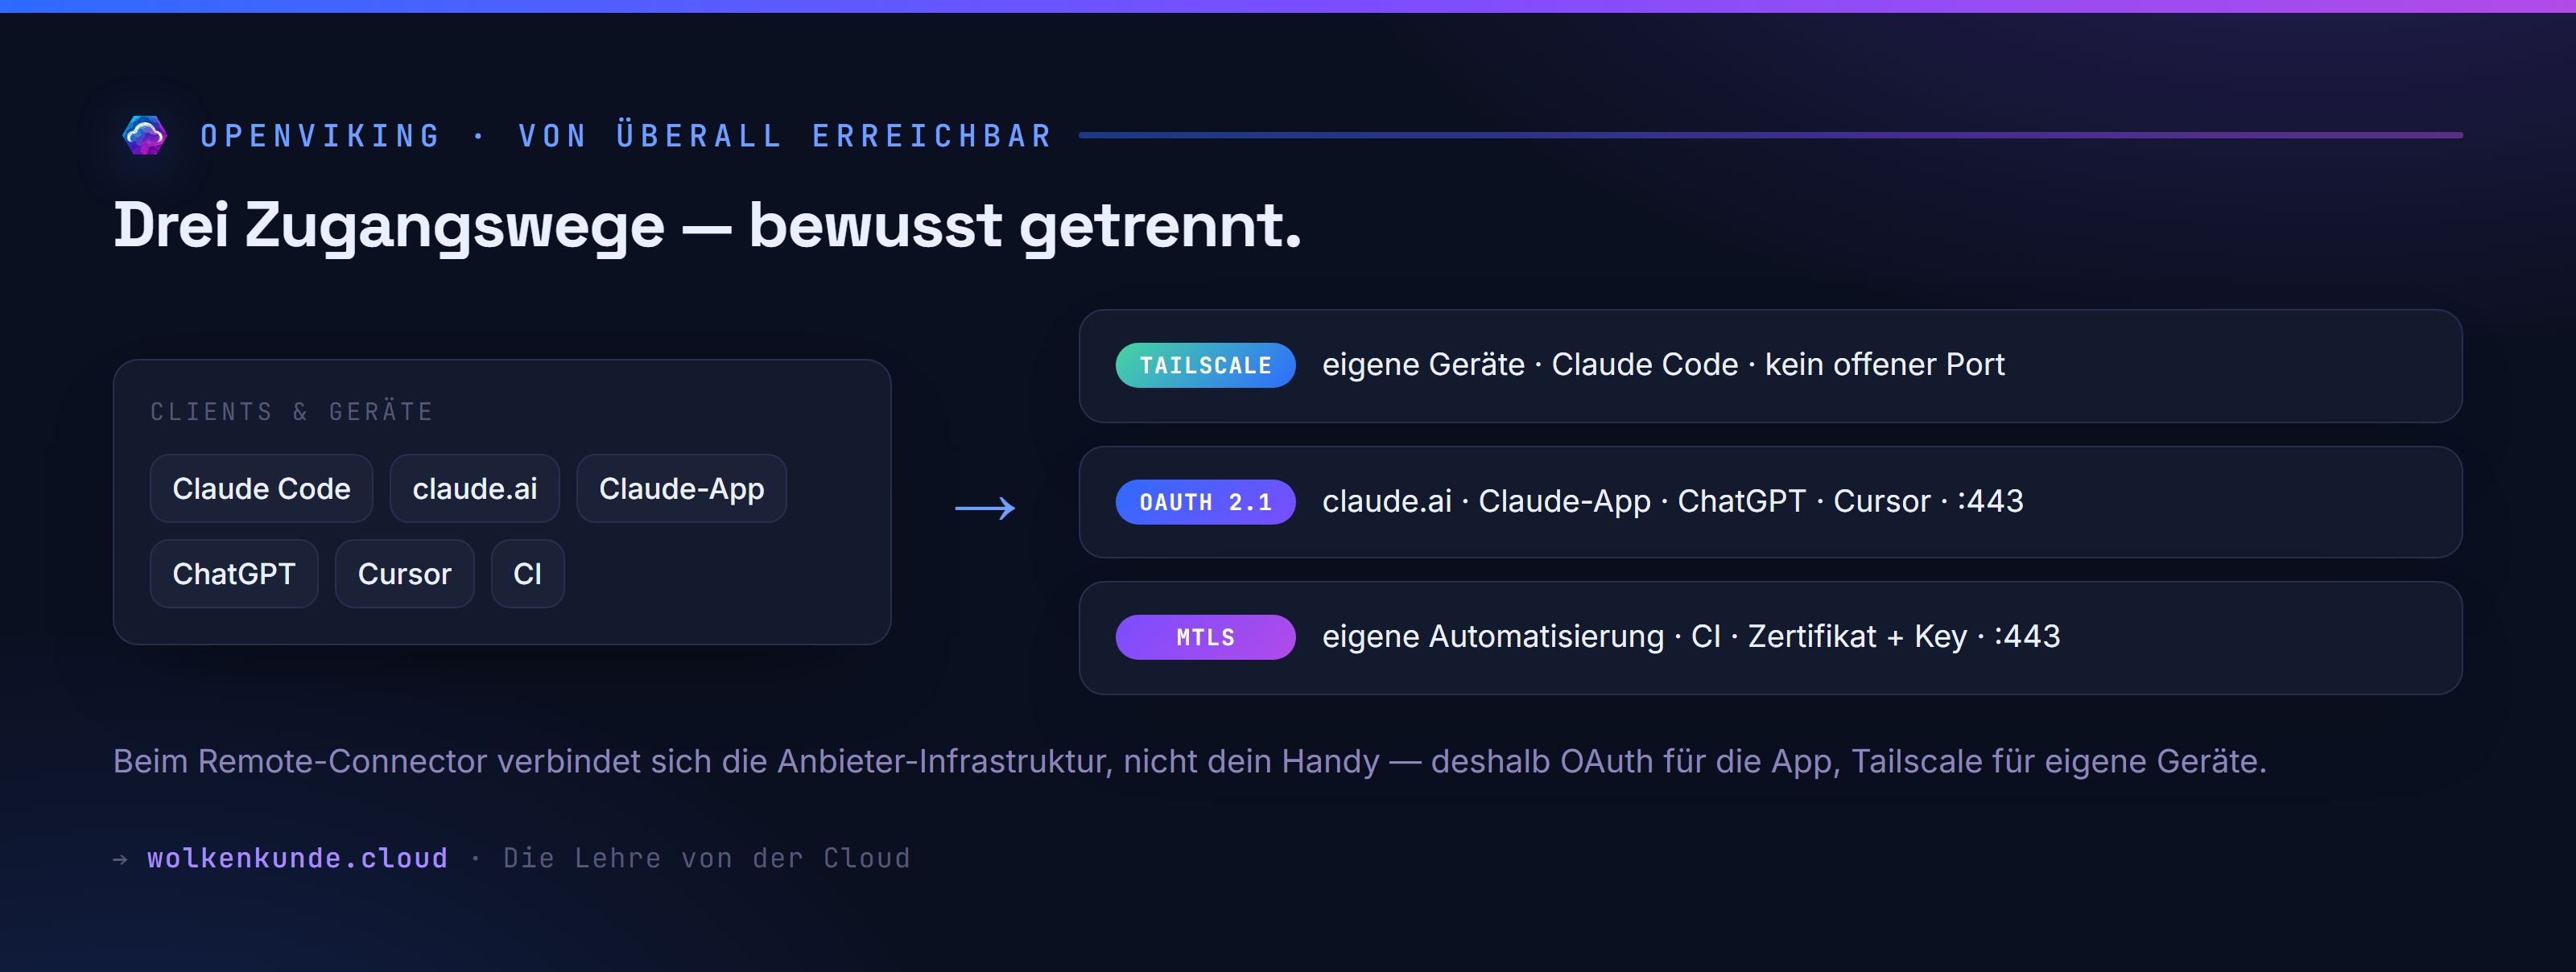
- Tailscale ist der Regelweg für eigene Geräte (Laptop, Desktop, Claude Code). Der Dienst hängt an einer Mesh-Adresse, kein Port ist im Internet offen.
- OAuth 2.1 auf Port 443 ist für alles, was aus einem Rechenzentrum kommt: claude.ai, die Claude-App, ChatGPT, Cursor. Anmeldung per OAuth mit PKCE und Zustimmungsdialog.
- mTLS auf 443 ist für eigene Automatisierung und CI — abgesichert durch ein Client-Zertifikat plus API-Key.
Warum drei und nicht einer? Wegen eines Details, das man leicht übersieht: Bei einem Remote-MCP-Connector verbindet sich nicht dein Endgerät zum Server, sondern die Infrastruktur des Anbieters. Tailscale auf dem Handy hilft der Claude-App also nicht — deren Anfrage kommt aus einem Rechenzentrum, nicht vom Telefon. Deshalb OAuth für die App, Tailscale für die eigenen Geräte.
Der Beweis: dieselbe Frage, drei Clients
Reden ist billig — hier ist es in Aktion. Dieselbe Frage („Was habe ich heute in Viking als Learnings hinterlegt?”), gestellt aus drei verschiedenen Clients, jeder auf seinem eigenen Zugangsweg, alle mit demselben Gedächtnis dahinter.
Drei Geräte, drei Wege, eine Wissensbasis. Genau das ist gemeint mit „von jedem Gerät bedienbar”.
Absicherung: fünf Schichten
Eine zentrale Wissensbasis, die alle Projekte speist, verlangt Sorgfalt. Die Absicherung liegt auf fünf Ebenen — die letzte ist die wichtigste, weil sie technisch nicht erzwingbar ist:
- Netzwerk — SSH nur von einer definierten Quelle, der Anwendungsport 1933 ist explizit verboten (nicht bloß „nicht erlaubt”), dazu
ufw,fail2ban, automatische Sicherheitsupdates. - Transport — Tailscale ist WireGuard-verschlüsselt; der öffentliche Fallback läuft über TLS, mTLS nur im Modus
require_and_verify(jede Anfrage ohne gültiges Zertifikat endet im TLS-Handshake, die Anwendung sieht sie nie). - Schlüssel — getrennt in Root Key (nur Kontenverwaltung, keine Daten-APIs) und User Key (liest und schreibt Inhalte, je Gerät ein eigener). Verlorener Laptop = ein Schlüssel gesperrt, nicht alle.
- Mandantentrennung — ein Konto je Kontext. So spielt ein Recall in Projekt A niemals Wissen aus Projekt B ein — eine Frage der Vertraulichkeit und der Qualität.
- Was hineingeht — keine Kunden- und Firmennamen, keine URLs, Tenant-IDs, Secrets, personenbezogenen Daten. Ein Learning beschreibt einen Mechanismus, keinen Kunden. Diese Schicht kann keine Technik erzwingen — dafür ist der Diff-Review da.
Der ehrliche Teil
Kein Aufbau ist umsonst. Was man vorher wissen sollte:
- Kein Hochverfügbarkeitsbetrieb. Eine VM, ein Standort. Fällt sie aus, ist die Basis bis zur Wiederherstellung nicht abrufbar. Vertretbar, weil der Server der Verteiler ist, nicht der Erzeuger: Die Learnings entstehen als Markdown in den Projekt-Repos und lassen sich neu einspielen.
- Kosten. Bei Hetzner rund 6 €/Monat (klein, externer Embedding-Provider) bis ~28 €/Monat (mit lokalem Ollama für vertrauliche Inhalte). Dieselbe Architektur auf Azure wäre das 4–6-Fache — dort läuft der Blog, die private Wissensbasis liegt bewusst auf Hetzner. Das VPN kostet nichts: Tailscale ist für Einzelnutzer kostenlos.
- Embedding-Provider ist eine Vertrauensentscheidung. Bei einem externen Anbieter verlassen die Inhalte die eigene Infrastruktur. Wer das nicht will, nimmt das lokale Backend oder das
local-embed-Profil mit Ollama — dann bleibt alles auf der VM (Achtung: das eingebaute Standardmodell ist chinesisch, für DE/EN explizit ein passendes setzen). - Sicherung nicht vergessen.
backup.shlegt standardmäßig lokal ab — das schützt vor Bedienfehlern, nicht vor Verlust der VM. Für echten Schutz eine Auswärtskopie konfigurieren. - Löschen und Aufbewahrung gehören dir. Ein eigenes Gedächtnis heißt: eigener Lebenszyklus — nicht nur, was reinkommt, sondern was wieder raus muss. Der Agent kann Einträge auf Zuruf über die MCP-Werkzeuge auf dem
viking://-Filesystem entfernen, wenn der User-Key die passenden Rechte hat; der Vektorindex fällt dabei mit. Zwei Dinge muss man bewusst mitziehen: git-basierte Learnings an der Quelle (dem Repo) löschen — sonst holt der nächste Sync sie zurück — und die Backups, die eigenständig altern. Für die dynamischeuser/-Ebene (Sessions, Erinnerungen) lohnt zusätzlich eine bewusste Aufbewahrungsfrist. Unabhängigkeit vom Anbieter bedeutet eben auch, die Löschregel selbst zu setzen. - Lizenz. OpenViking ist AGPLv3 (CLI-Teile Apache 2.0). Für den internen Betrieb unkritisch; bei Weitergabe einer abgeleiteten Lösung prüfen.
Lohnt sich das?
Für einen einzelnen Chat: nein. Für jemanden, der täglich mit KI arbeitet, über mehrere Werkzeuge und Geräte hinweg, und dessen Wert im aufgebauten Kontext liegt: sehr. Der Unterschied ist der zwischen „die KI ist ein cleverer Fremder, jeden Morgen neu” und „die KI kennt meine Regeln, meine Entscheidungen, meine Fehler von letztem Mal”.
Ein persönliches RAG als eigene Schicht macht genau das dauerhaft — und weil es unter den Agenten liegt statt in einem von ihnen, überlebt es jeden Werkzeugwechsel. Die Infrastruktur dafür ist überschaubar: eine kleine VM, drei Container, eine Datenplatte, drei Zugangswege. Der eigentliche Aufwand steckt nicht in der Technik, sondern in der Disziplin, was hineingeht — und genau die ist es, die den Bestand über Jahre wertvoll hält.
Stand: August 2026. Betriebene Version OpenViking v0.4.16. Preise sind Näherungswerte (Hetzner-Listenpreise, Azure-Retail-API, Westeuropa) und vor einer Entscheidung im Konfigurator zu prüfen.
Quellen
- OpenViking (Upstream, volcengine) — AGPLv3 (Hauptprojekt), Apache 2.0 (CLI-Teile).
- Tailscale — das Mesh-VPN für den Regelweg (kostenlos für Einzelnutzer).
- Caddy — Reverse Proxy mit automatischem TLS und mTLS.
- Hetzner Cloud — die VM.
- Model Context Protocol (MCP) — das Protokoll, über das die Clients das Gedächtnis ansprechen.
Siehe auch
- Skills und Agenten im Team teilen — mit einem eigenen Claude-Code-Marketplace — die andere Hälfte einer durchdachten KI-Arbeitsumgebung: geteilte Fähigkeiten statt geteiltem Gedächtnis.