 AI & Agents·16. September 2026·17 min Lesezeit
tgrep spart keine Tokens. Drei Zeilen in der AGENTS.md schon.
Tokens werden teurer. Noch subventionieren die Anbieter, aber die tatsächlichen Kosten für Inferenz verschwinden nicht, sie werden irgendwann weitergereicht. Wer heute Agenten in seine Arbeit einbaut, rechnet also mit einem Preis, der morgen ein anderer ist.
Es gibt aber einen zweiten Grund, sparsam zu sein, und der wirkt sofort: Je voller das Kontextfenster ist, desto schlechter arbeitet das Modell. Nicht erst, wenn es überläuft — schon davor. Anthropic nennt das „context rot”. Ein Agent, der sich mit 400.000 Tokens Suchergebnissen vollgeladen hat, ist nicht nur teuer, er ist auch schlechter.
Entsprechend viel wird gerade angeboten. An jedem zweiten Werkzeug steht „spart Tokens”. Wir haben uns eines davon vorgenommen, es installiert und nachgemessen, statt die Zahlen aus der Ankündigung abzuschreiben.
Das Ergebnis vorweg: Das Werkzeug hält, was es verspricht — nur nicht das, was draufsteht. Und am Ende haben wir es nicht genommen.
Die Landkarte: drei Achsen, unter die alles fällt
Wer sich das Feld ansieht, findet Dutzende Ansätze, die nichts miteinander zu tun zu haben scheinen. Sie lassen sich auf drei Achsen sortieren, und diese Einteilung hilft beim Einordnen jedes neuen Werkzeugs.
Achse 1 — weniger hineingeben. Was gar nicht erst im Kontext landet, muss niemand bezahlen. Hierher gehören Kompressionsverfahren wie Caveman, das Grammatik weglässt und Fakten behält. Hierher gehört auch, dass Werkzeugbeschreibungen nicht dauerhaft mitgeführt, sondern bei Bedarf nachgeladen werden.
Achse 2 — weniger behalten. Was drin ist, muss nicht für immer drin bleiben. Zusammenfassen des bisherigen Verlaufs, Notizen in Dateien statt im Gespräch, ein Gedächtnis, aus dem einzelne Einträge geholt werden.
Achse 3 — woanders verarbeiten. Die billigsten Tokens sind die, die ein anderer Prozess ausgibt. RAG-Systeme, Subagenten mit eigenem Fenster, Werkzeuge, die selbst rechnen statt Rohdaten zurückzugeben.
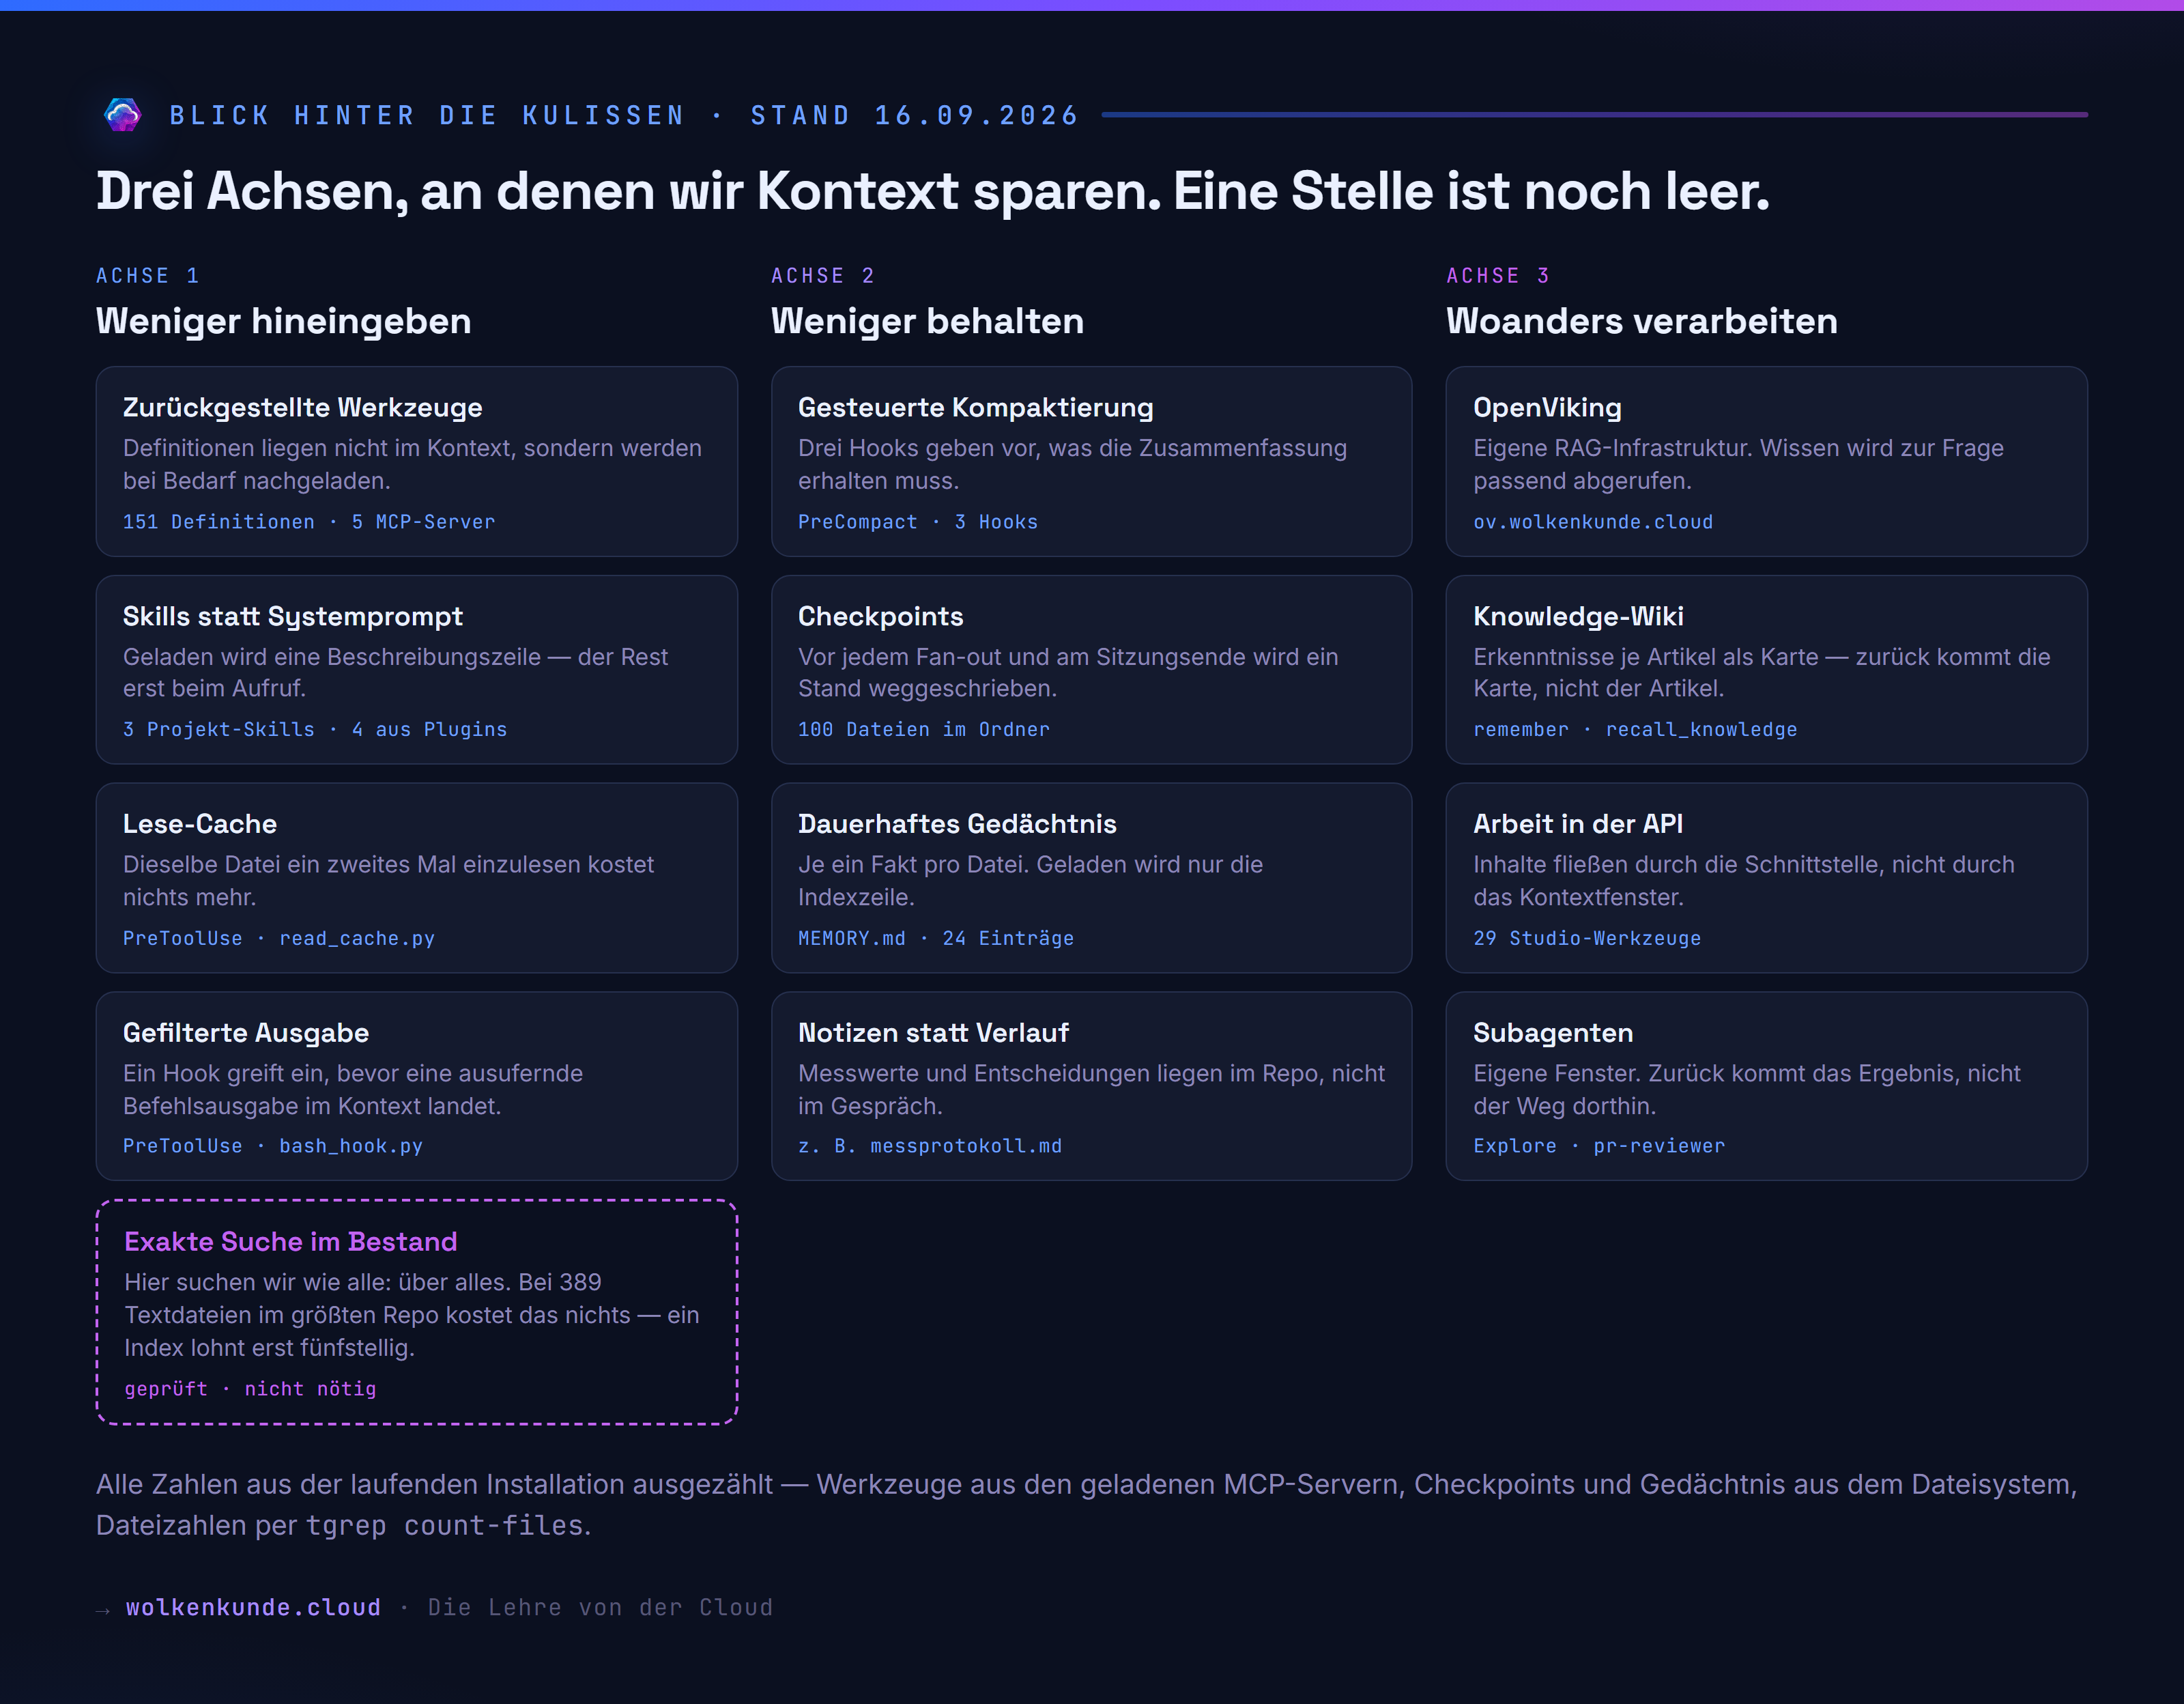
Die vierte Möglichkeit fehlt in dieser Liste bewusst: das Fenster einfach größer machen. Das hilft gegen den Abbruch, nicht gegen die Kosten und nicht gegen die nachlassende Qualität.
Was eine Sitzung wirklich kostet
Bevor es um Werkzeuge geht, eine Zahl zur Einordnung. Wir haben einen Agenten gefragt, wie viele Dateien in einem bestimmten Ordner liegen. Eine Frage, eine Zahl als Antwort, zwei Züge.
Kosten: 59.125 Tokens und 0,32 US-Dollar. Davon waren 4 Tokens die Frage. Der Rest ist Systemprompt, Verhaltensregeln und Werkzeugbeschreibungen — die Grundlast, bevor irgendetwas passiert.
Dagegen gerechnet: Eine einzige unbedachte Suche in einem mittelgroßen Repository liefert 116.121 Tokens zurück. Das Doppelte der gesamten Grundlast, in einem einzigen Werkzeugaufruf.
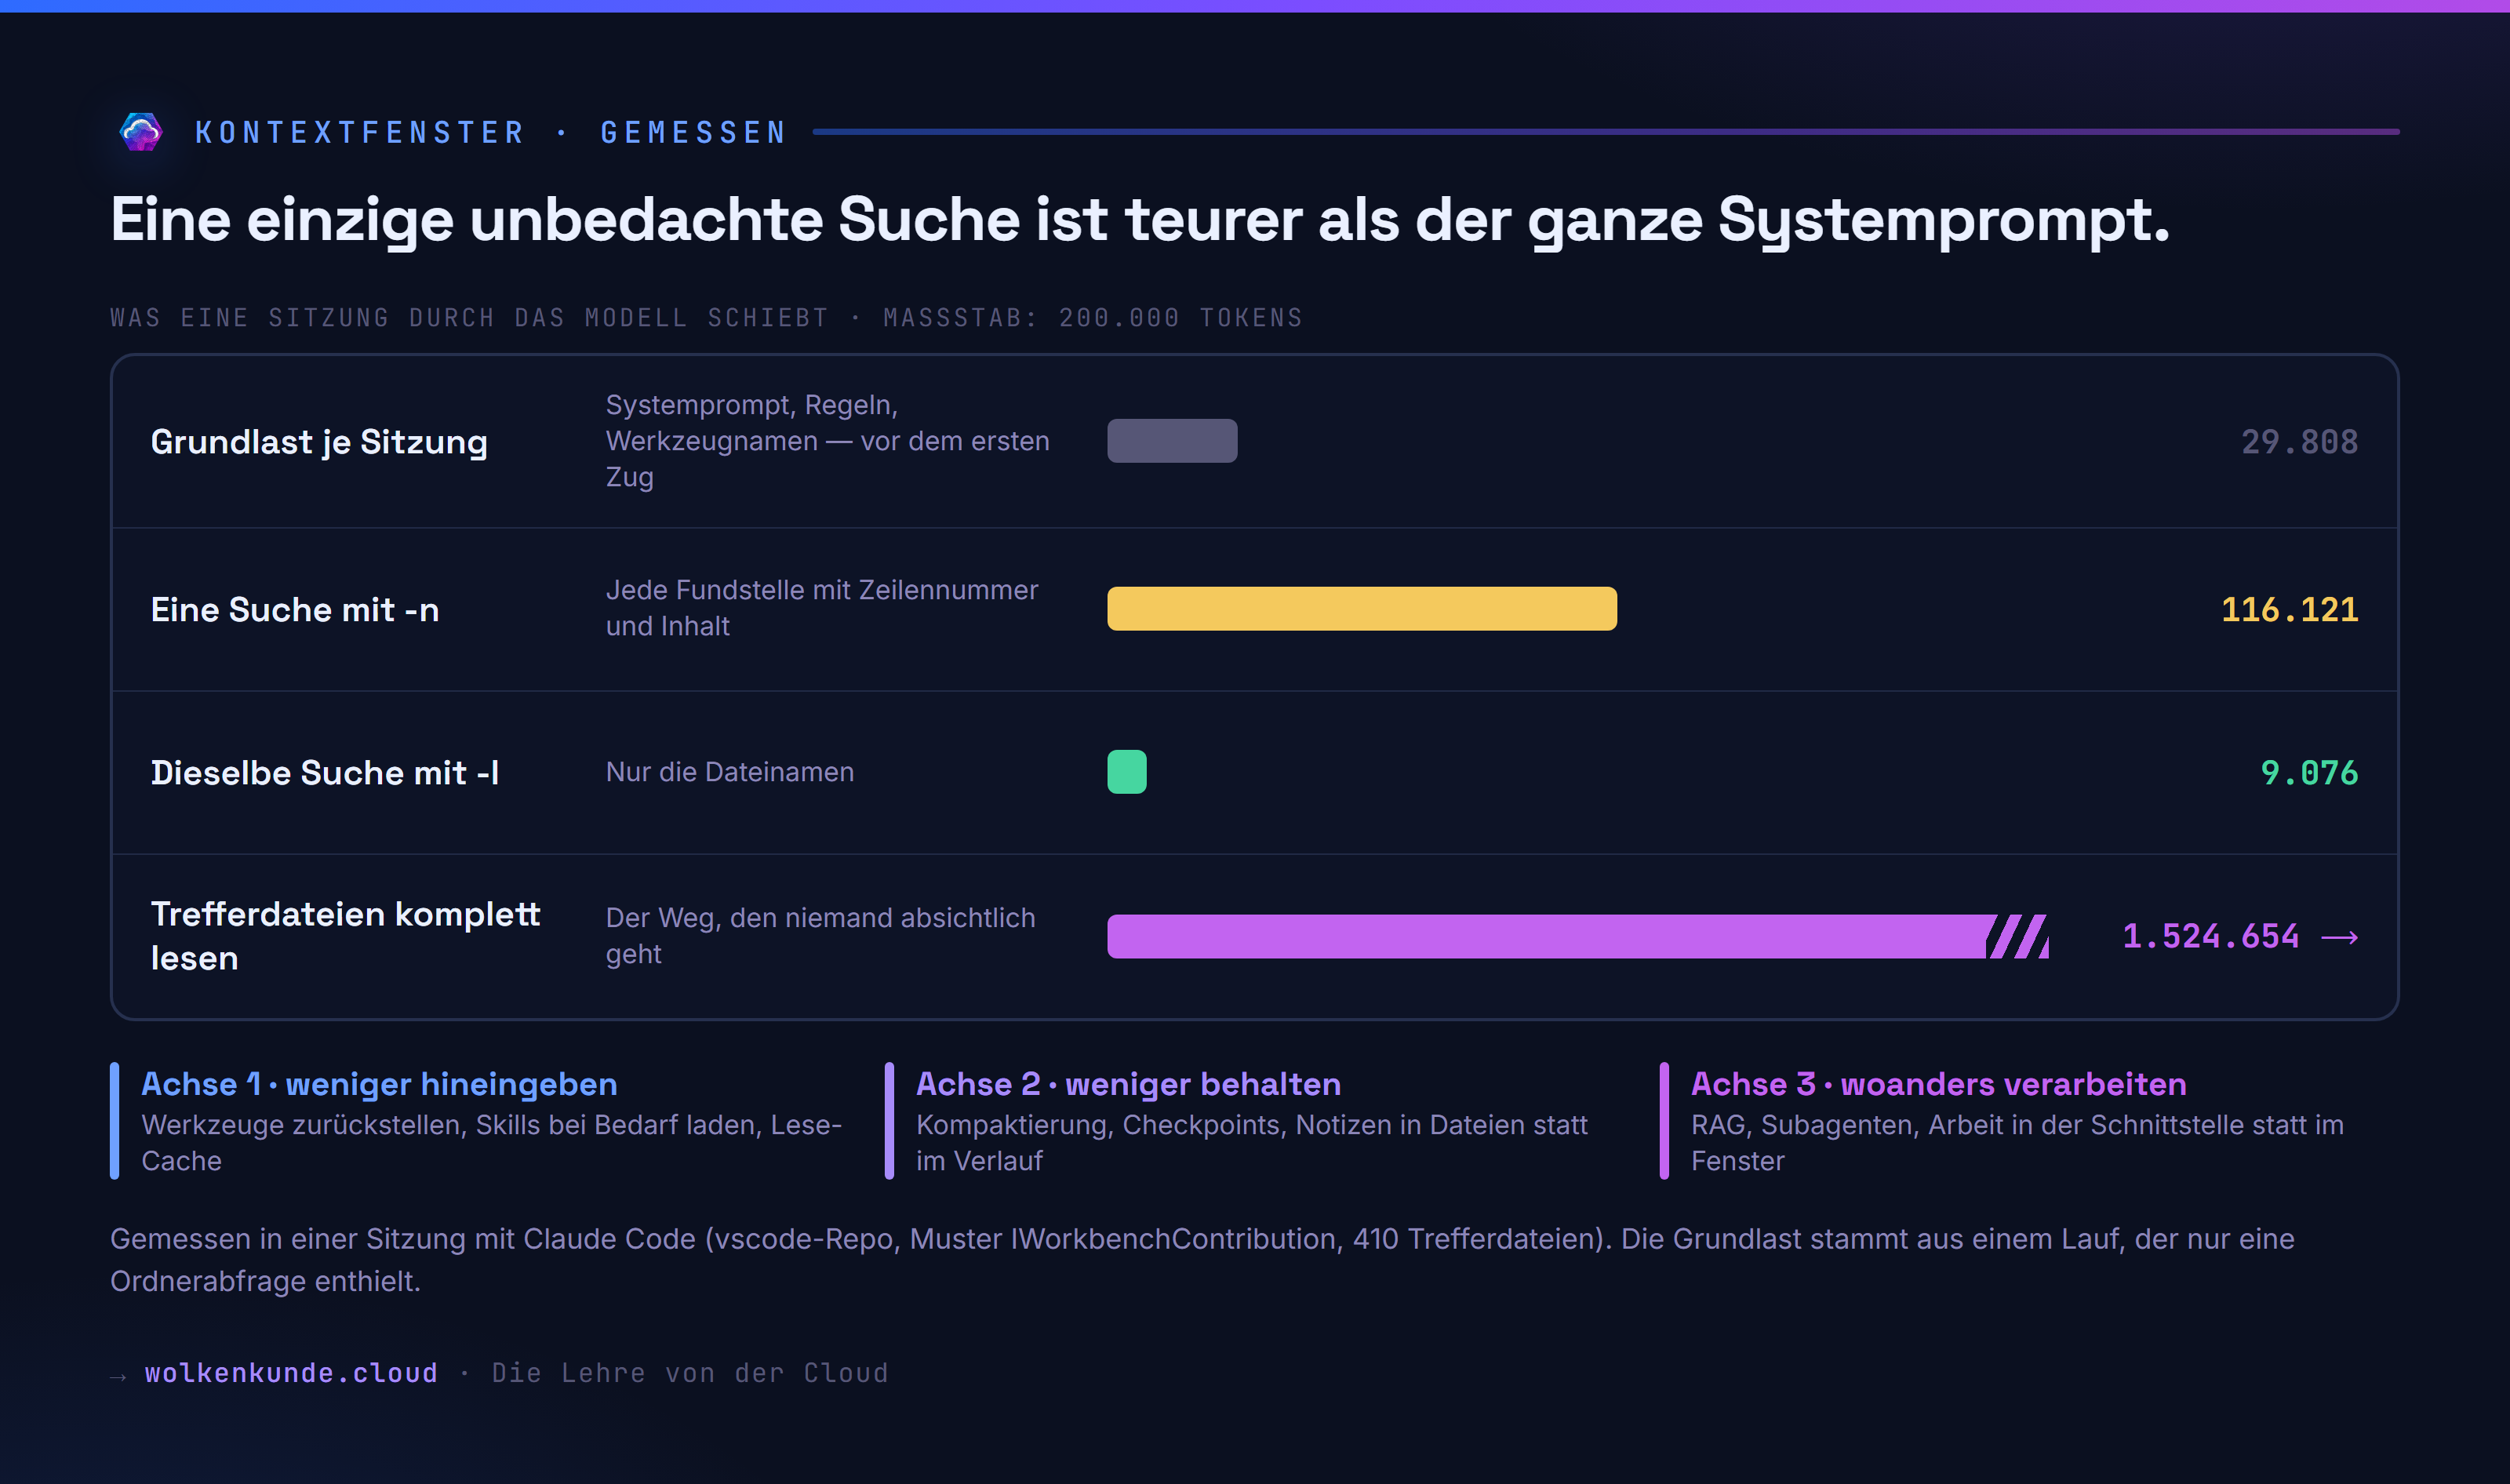
Der unterste Balken ist der Weg, den niemand absichtlich geht: die Trefferdateien einfach komplett lesen. 1.524.654 Tokens. Er steht da, weil er die Obergrenze markiert — und weil ein Agent ohne klare Vorgabe durchaus dorthin gerät.
Blick hinter die Kulissen: was wir betreiben
Bevor wir ein neues Werkzeug aufnehmen, gehört auf den Tisch, was ohnehin schon läuft. Die folgenden Zahlen sind ausgezählt, nicht geschätzt.
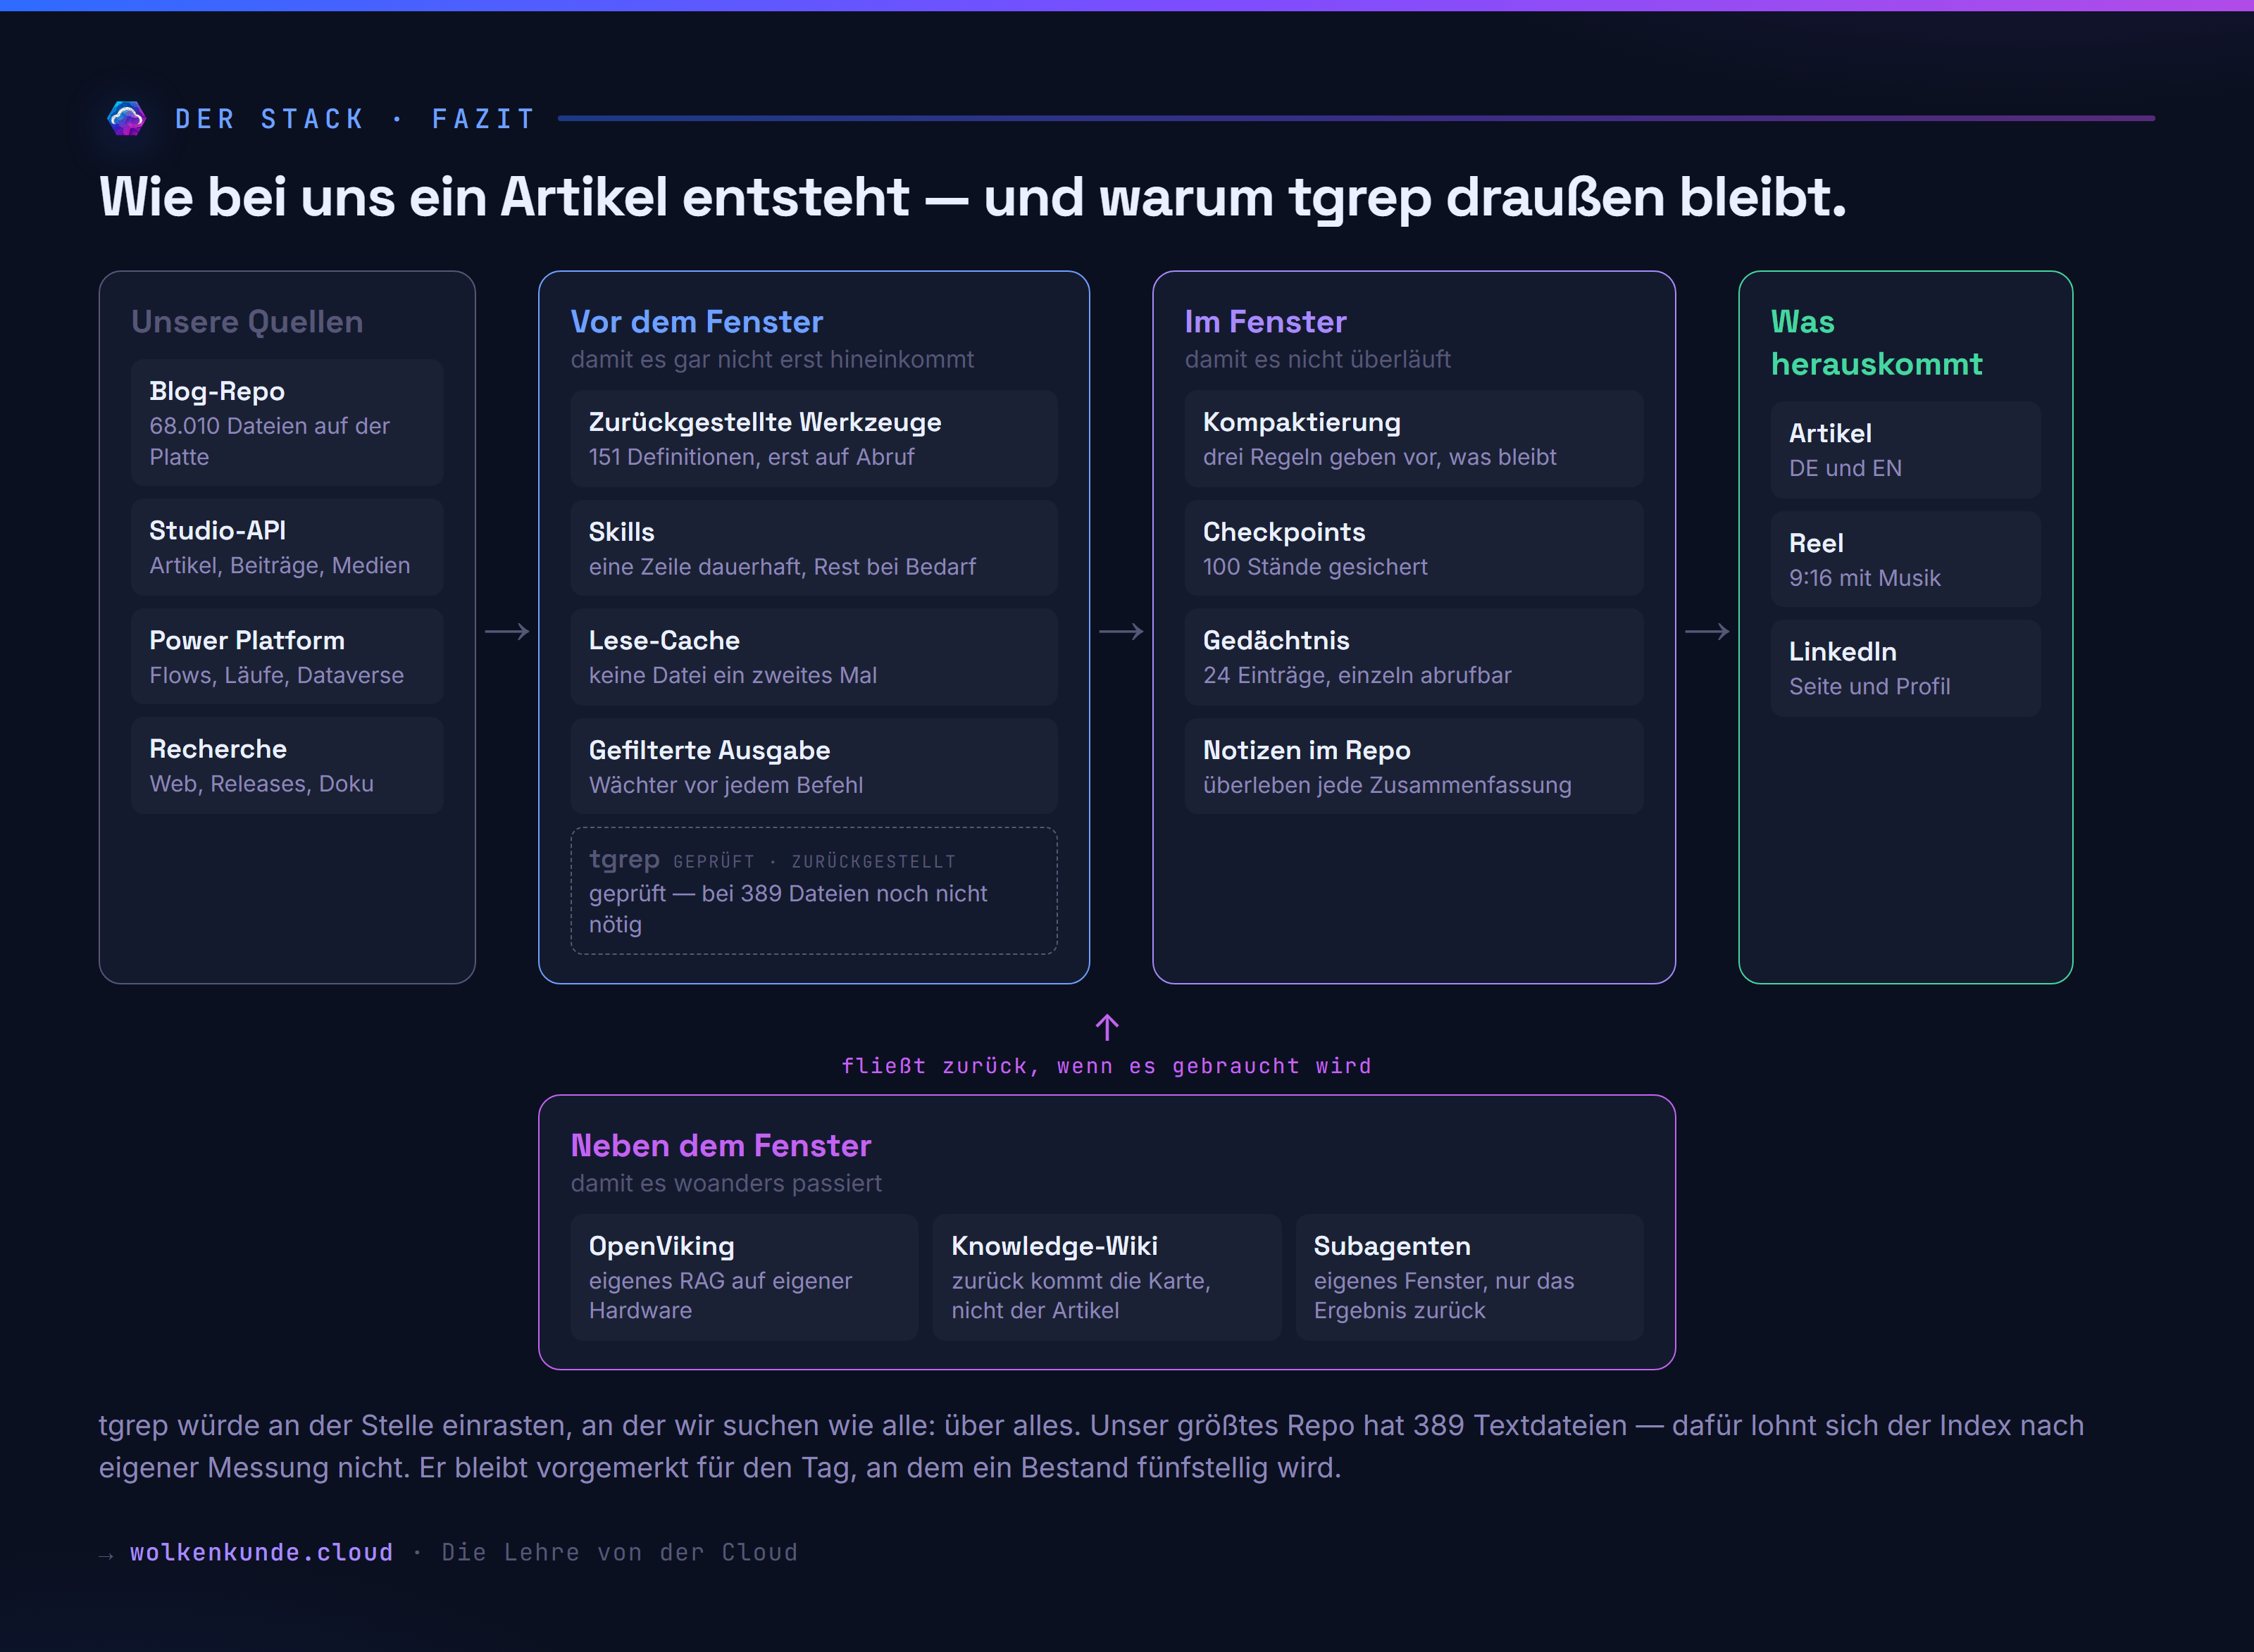
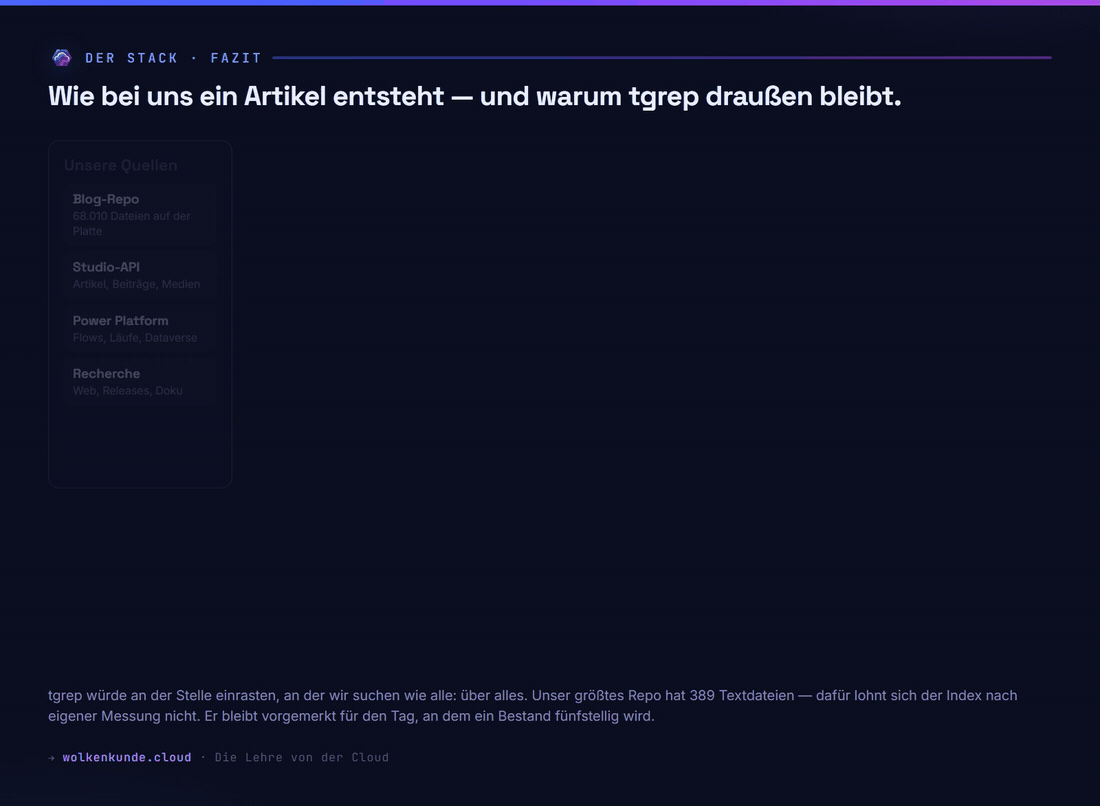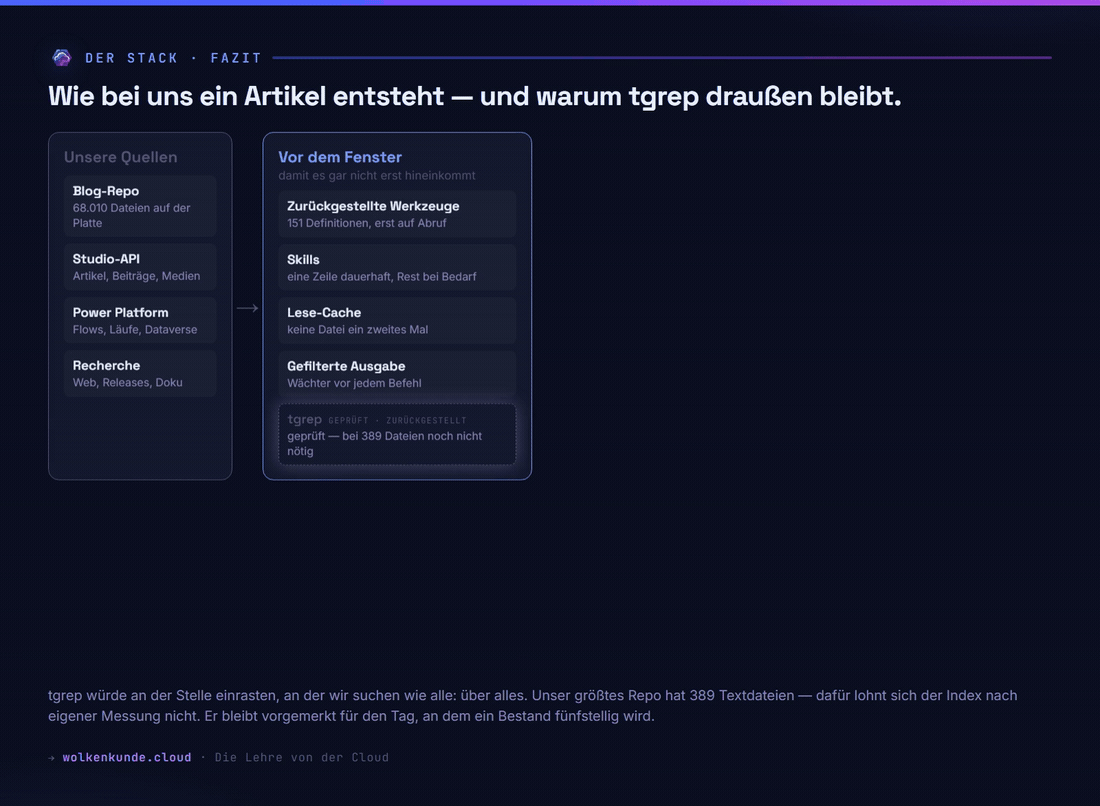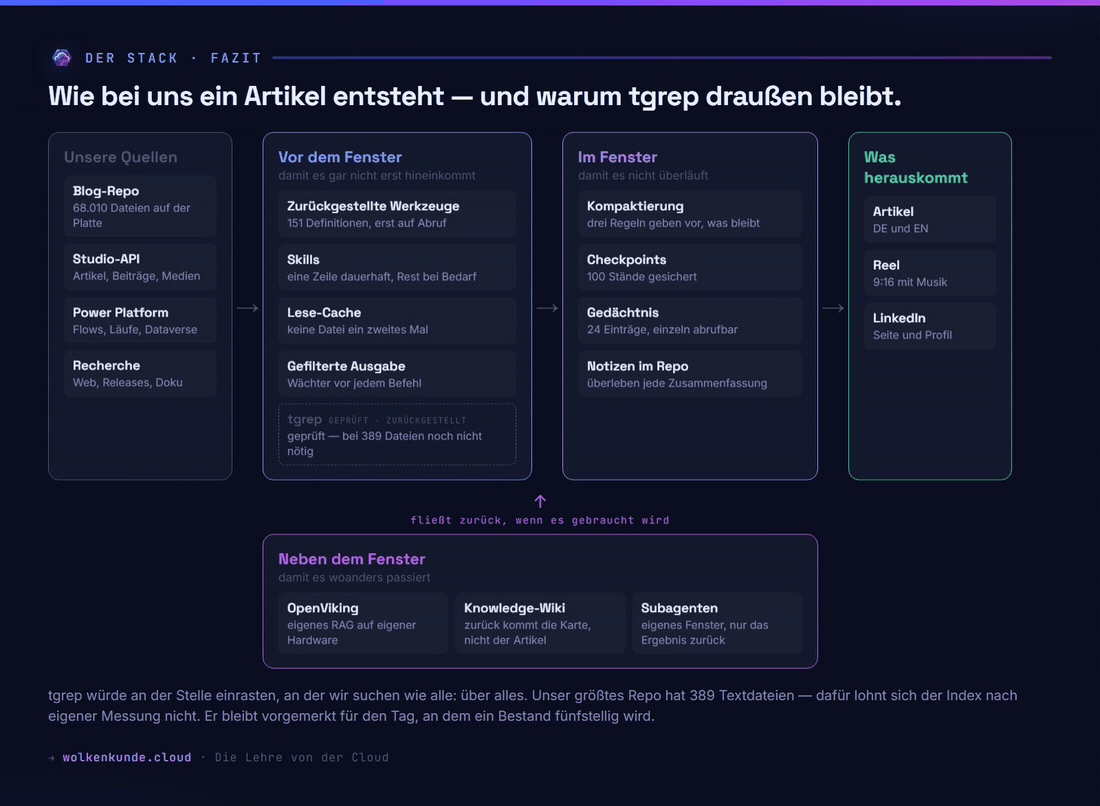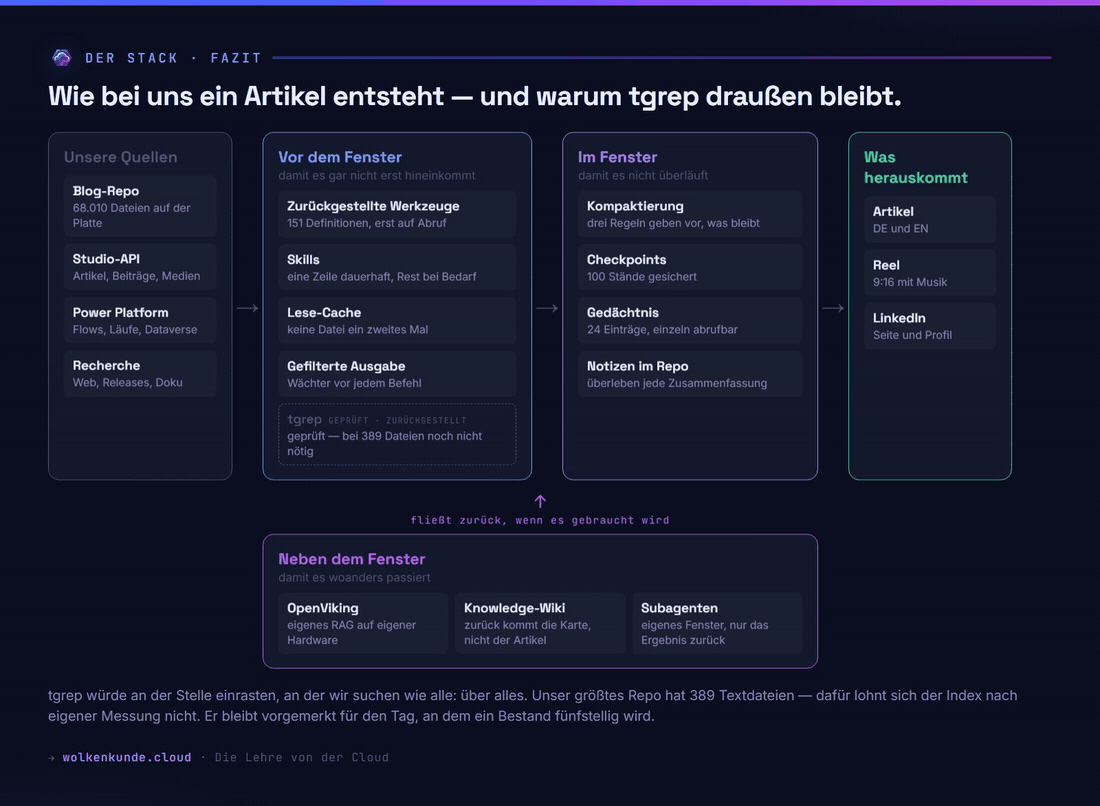
Vor dem Fenster. Unsere Agenten haben Zugriff auf 151 Werkzeugdefinitionen aus fünf MCP-Servern — Studio-API, Power Automate, Browser-Steuerung, Gedächtnis, Fensterauswahl. Würden alle Beschreibungen dauerhaft mitgeführt, wäre das Fenster voll, bevor die erste Frage kommt. Stattdessen sind nur die Namen bekannt; die Beschreibung wird nachgeladen, wenn das Werkzeug gebraucht wird. Dazu Skills, von denen nur eine Beschreibungszeile dauerhaft im Kontext steht, ein Lese-Cache, der dieselbe Datei kein zweites Mal einliest, und ein Wächter vor jedem Befehl, der ausufernde Ausgaben abfängt.
Im Fenster. Wird es voll, wird der bisherige Verlauf zusammengefasst. Das Risiko dabei ist, dass die Zusammenfassung das Falsche wegwirft, deshalb hängen drei Regeln davor, die vorgeben, was überleben muss: Codeänderungen, Entscheidungen, Dateipfade. Dazu 100 Checkpoints aus bisherigen Sitzungen und ein Gedächtnis aus 24 Einzeldateien, von dem beim Start nur das Inhaltsverzeichnis geladen wird.
Neben dem Fenster. OpenViking als eigenes RAG auf eigener Hardware. Ein Knowledge-Wiki im Studio, das zu jedem Artikel die Kernaussagen als Karte speichert — beim nächsten Mal kommt die Karte zurück, nicht der Artikel. Und Subagenten, die in einem eigenen Fenster zwanzig Dateien durchsuchen und drei Sätze zurückmelden.
Eine Stelle ist offen: die Suche im Bestand. Dort suchen wir wie alle — über alles. Genau dort würde tgrep ansetzen.
Der Neuzugang: tgrep
Es ist microsoft/tgrep, veröffentlicht unter MIT-Lizenz und inzwischen in der GitHub Copilot CLI im Einsatz. Im Kern ist es ripgrep mit vorgebautem Index und einem Server davor.
Statt bei jeder Suche alle Bytes zu lesen, zerlegt tgrep einmalig alle Textdateien in Trigramme — Folgen von drei Zeichen — und legt eine sortierte Nachschlagetabelle an.
Wie ein Trigramm funktioniert
Man schiebt ein Fenster von drei Zeichen über den Text: „Hallo” ergibt Hal, all, llo. Ein Text mit n Zeichen hat n − 2 davon. Mehr Regel gibt es nicht — keine Wörter, keine Grammatik, keine Bedeutung.
Der Index dreht die Richtung um. Statt „Datei → Inhalt” speichert er „Trigramm → welche Dateien es enthalten”. Wie das Stichwortverzeichnis hinten in einem Fachbuch, nur dass die Stichwörter alle vorkommenden Dreierfolgen sind.
Gesucht wird dann über Schnittmengen:
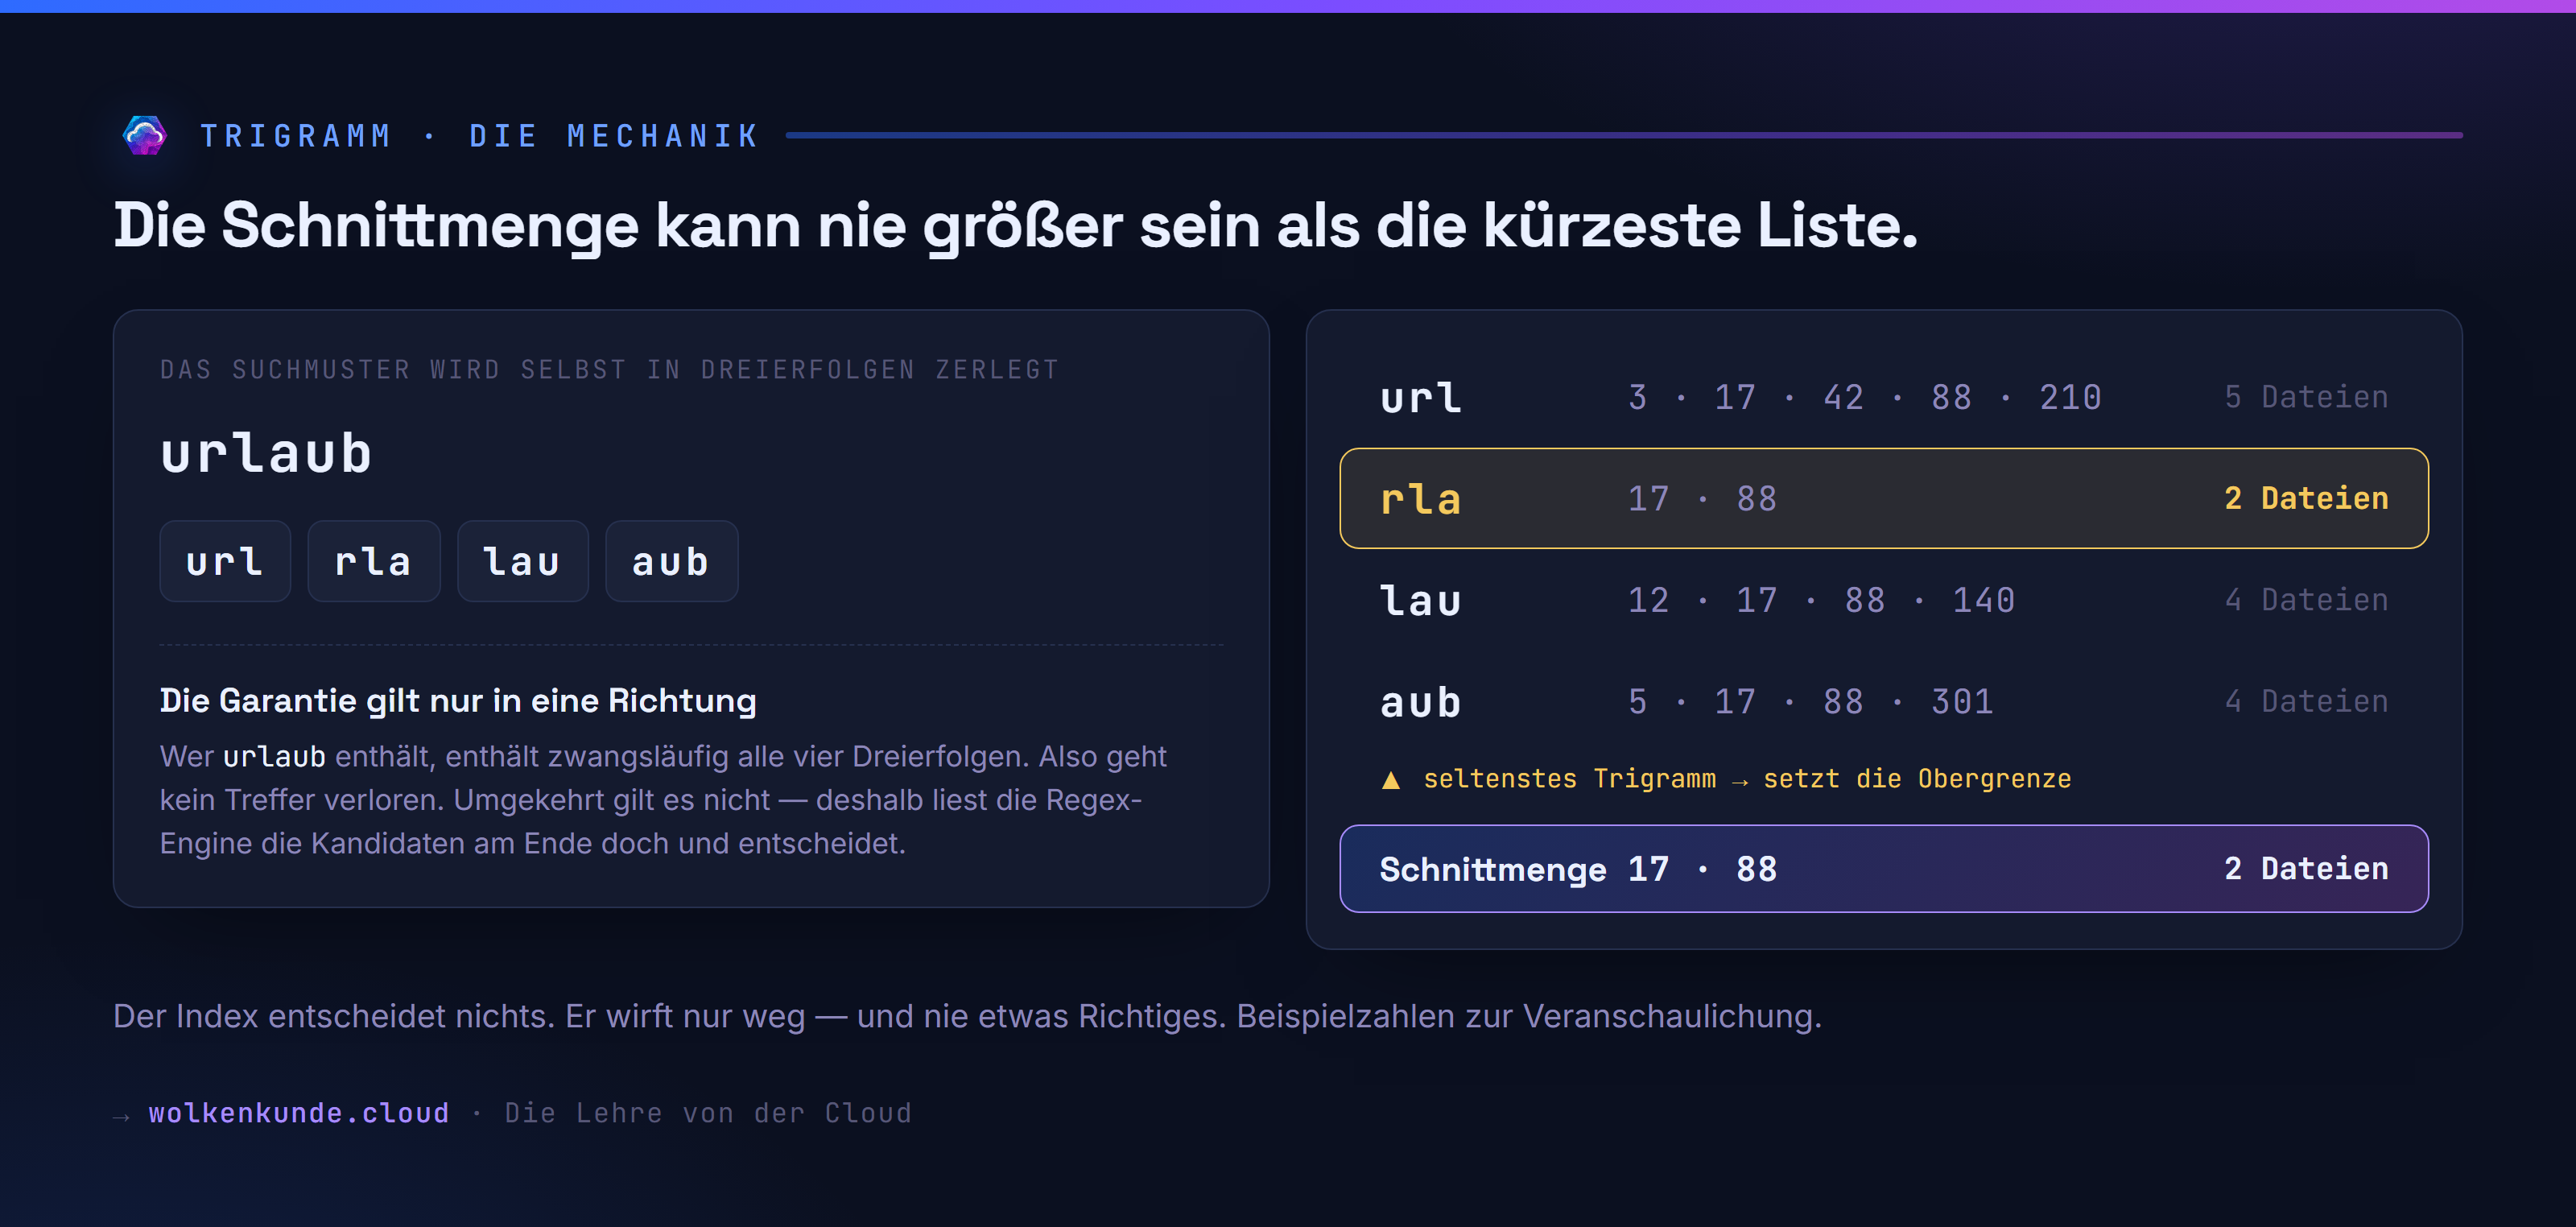
Der Satz, um den sich alles dreht: Die Schnittmenge kann nie größer sein als die kürzeste Einzelliste. Ein einziges seltenes Trigramm im Suchmuster wirft damit fast den ganzen Bestand weg. Man braucht keine Statistik, nur Mengenlehre aus der Mittelstufe.
Die Garantie gilt dabei nur in eine Richtung: Wer urlaub enthält, enthält zwangsläufig auch url, rla, lau und aub. Also geht kein Treffer verloren. Umgekehrt gilt es nicht — eine Datei kann alle vier Dreierfolgen enthalten, ohne das Wort zu enthalten. Deshalb liest die Regex-Engine die Kandidaten am Ende doch und entscheidet. Der Index entscheidet nichts, er wirft nur weg — und nie etwas Richtiges. Genau deshalb liefert tgrep zeichengenau dasselbe Ergebnis wie grep.
Die Grenze gehört dazu: Ein Suchmuster braucht mindestens drei zusammenhängende feste Zeichen. Wer nach .* sucht oder nach a.c, liefert dem Index nichts zum Schneiden.
Der Aufbau
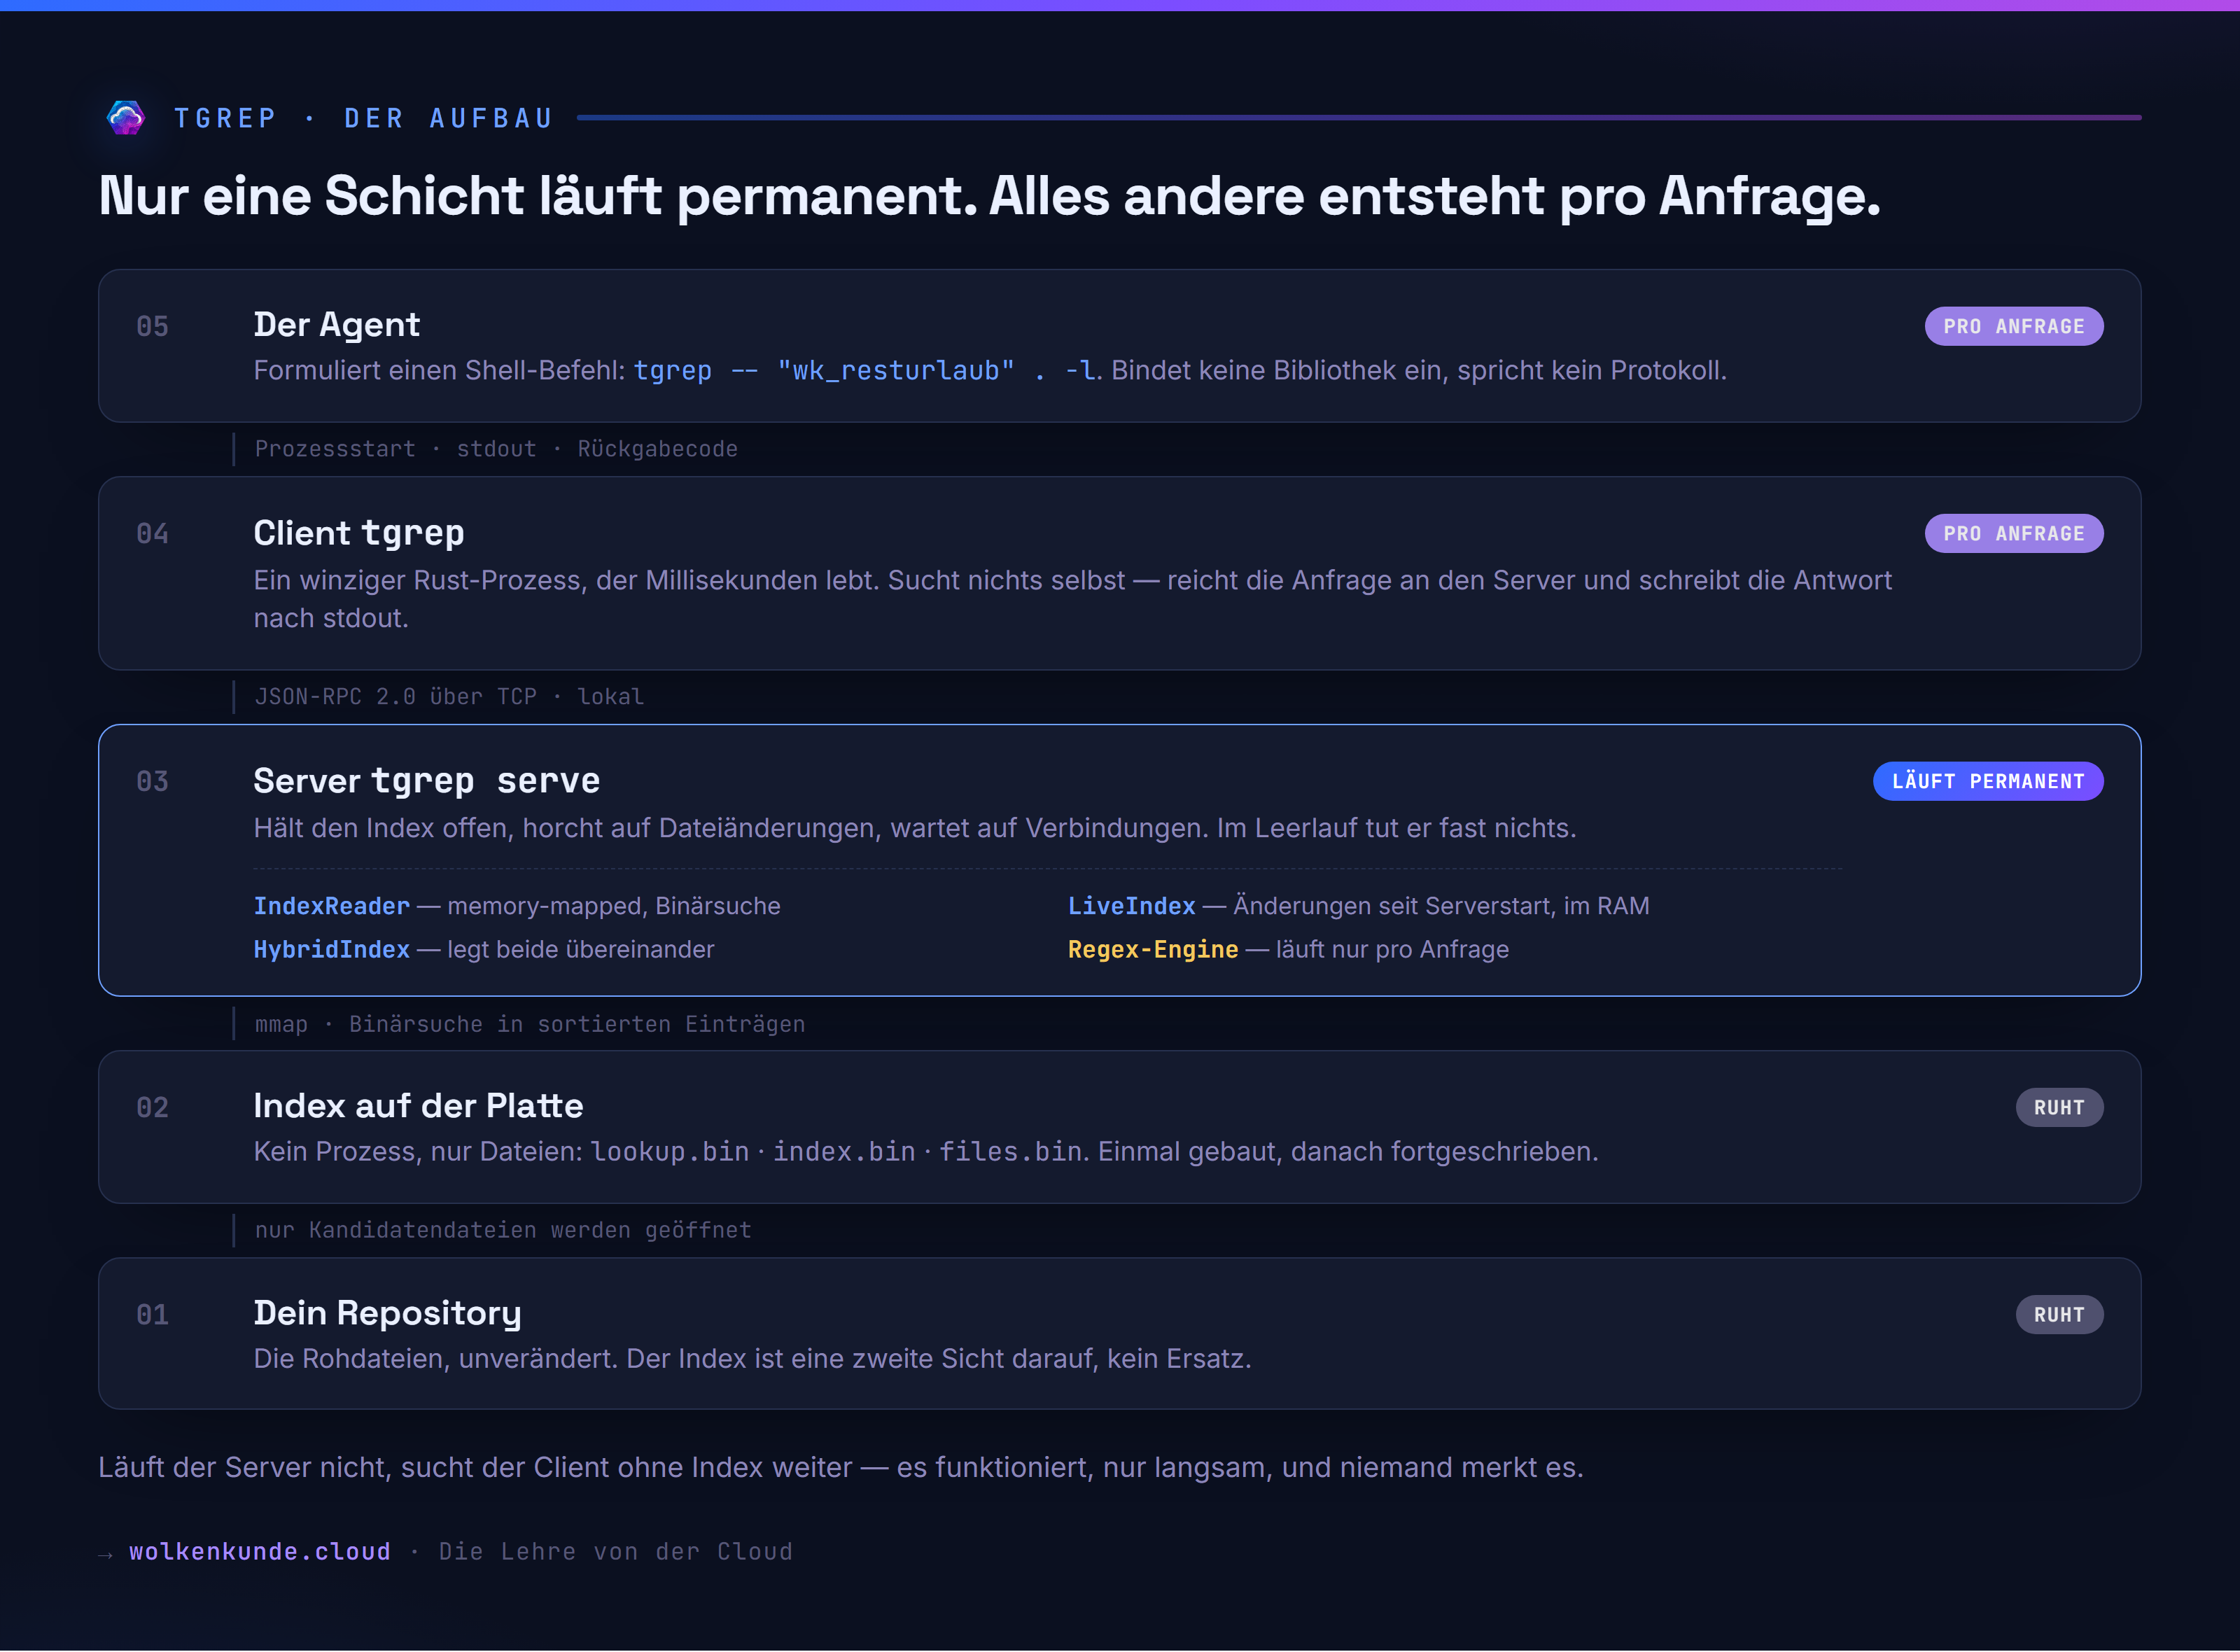
Wichtig für das Verständnis ist die Frage, was eigentlich dauerhaft läuft. Die Antwort: genau eine Schicht. Der Server hält den Index memory-mapped offen und horcht per File-Watcher auf Änderungen. Der Client, den der Agent aufruft, lebt Millisekunden — er reicht die Anfrage über TCP weiter und schreibt die Antwort nach stdout. Die Regex-Engine läuft nicht permanent, sondern pro Anfrage, und nur auf den Kandidatendateien.
Die naheliegende, aber falsche Annahme
Das Argument dahinter klingt einleuchtend: Ein Index spart Kontext, weil weniger Dateien gelesen werden. Trotzdem stimmt es nicht.
Man muss derselben Suche zwei getrennte Fragen stellen.
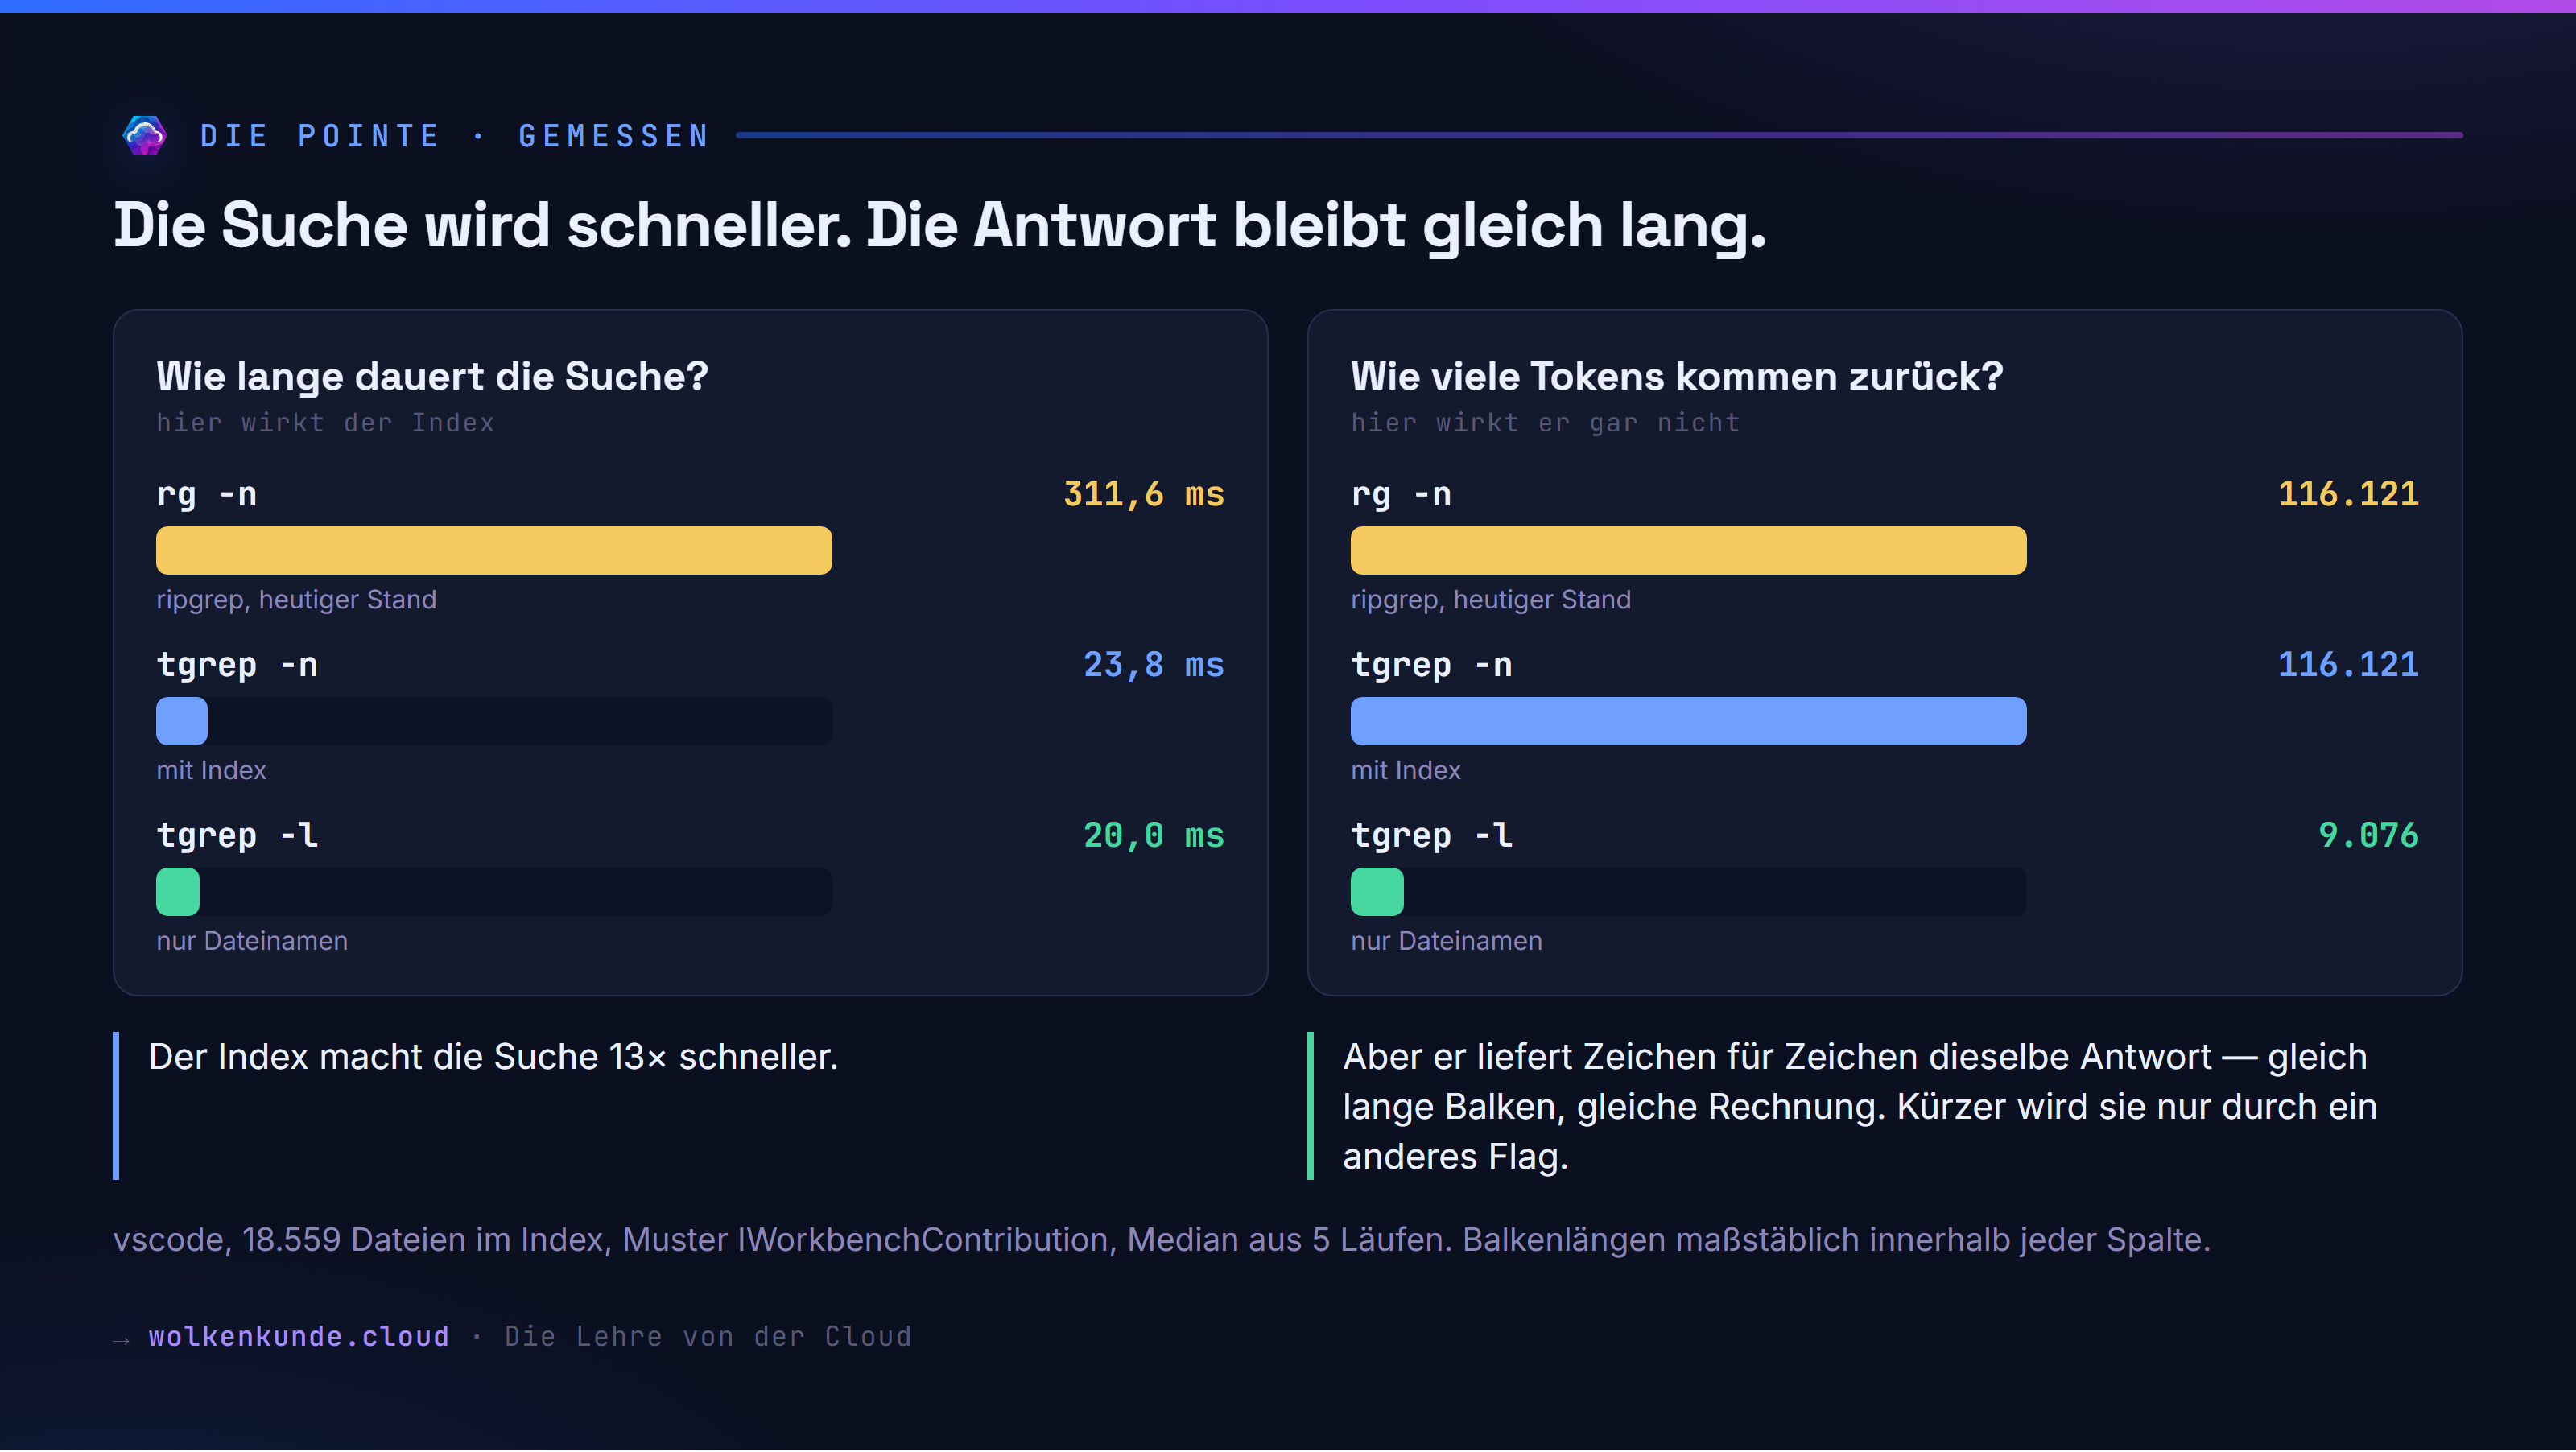
Erstens: Wie lange dauert die Suche? Da wirkt der Index. 311,6 Millisekunden mit ripgrep, 23,8 mit tgrep — dreizehnmal schneller.
Zweitens: Wie viele Tokens kommen zurück? Da wirkt er überhaupt nicht. 116.121 bei ripgrep, 116.121 bei tgrep. Dieselbe Zahl, weil es dieselbe Antwort auf dieselbe Frage ist, Zeichen für Zeichen. Im Bild rechts sind die beiden oberen Balken deshalb exakt gleich lang.
Kürzer wird die Antwort nur durch eine andere Frage. -l statt -n — nur die Dateinamen statt jeder Fundstelle — senkt dieselbe Suche von 116.121 auf 9.076 Tokens. Und das funktioniert mit ripgrep genauso, ohne Installation.
Drei Buchstaben, drei Antwortlängen
Weil es im Folgenden ständig um „die Regel” geht, vorab ganz konkret, was damit gemeint ist. An ripgrep selbst ändert sich nichts. Es ist derselbe Befehl, nur mit einem anderen Buchstaben:
rg -n "registerSingleton"   # jede Fundstelle: Datei, Zeilennummer, Zeileninhalt
rg -c "registerSingleton"   # nur: welche Datei, wie viele Treffer
rg -l "registerSingleton"   # nur: welche Dateien überhaupt
Drei Befehle, dasselbe Muster, dieselbe Wahrheit — aber völlig verschieden lange Antworten. Für die Frage „in wie vielen Dateien kommt das vor?” reicht die mittlere Zeile vollkommen.
Ohne Vorgabe greift ein Agent trotzdem meistens zur obersten. Das ist die ausführlichste Ausgabe, sie ist die naheliegende Voreinstellung, und so steht es in den allermeisten Beispielen, aus denen das Modell gelernt hat.
Die Regel ist deshalb kein Parameter, sondern ein Satz im Systemprompt — sie sagt dem Agenten, mit welcher der drei Zeilen er anfangen soll, und dass er die oberste erst nimmt, wenn er den Zeileninhalt wirklich braucht. Den Parameter wählt weiterhin er.
In Claude Code heißen diese drei Varianten output_mode: "content", "count" und "files_with_matches". Dieselbe Sache in anderer Verpackung.
Hands-on: die Messung
Alles Folgende ist nachgemessen mit tgrep 1.0.8 und ripgrep 15.2.0, beide als Release-Binärdateien, auf Windows 11. Zeitwerte sind Mediane aus fünf Läufen, der erste Lauf wird verworfen, weil er den Dateicache wärmt.
Einrichten
# Windows: Binärdatei aus den Releases, sonst Homebrew oder cargo
tgrep index .          # Index bauen
tgrep serve .          # Server starten, beobachtet Änderungen
tgrep -- "muster" .    # suchen
Nützlich vorweg, weil es die Größenordnung klärt:
tgrep count-files .
# 385 text files (167 binary skipped, 0 too large, 0 errors) in 11ms

tgrep count-files . --no-ignore
# 65015 text files (1510 binary skipped, 0 too large, 0 errors) in 55ms
Zwei Zahlen für dasselbe Verzeichnis, Faktor 169 dazwischen. Der Unterschied ist allein die Frage, ob .gitignore beachtet wird. Wer über Repository-Größen redet, sollte dazusagen, welche der beiden Zahlen er meint.
Was der Index kostet
| Bestand | Dateien | Bauzeit | Index auf Platte |
|---|---|---|---|
| unser Repo (git-Raum) | 706 | 236 ms | 12 MB |
unser Repo mit node_modules | 66.792 | 6,6 s | 468 MB |
| vscode | 18.559 | 13,2 s | 187 MB |
| Linux-Kernel | 96.009 | 12,5 s | 1,1 GB |
Rund ein Fünftel der Quellgröße als Index. Das steht in keiner Ankündigung und gehört in jede Entscheidung.
Wann er sich lohnt
Zwei Dinge entscheiden darüber: wie groß der Bestand ist und wie viele Dateien das Muster trifft. Als Matrix gelesen:
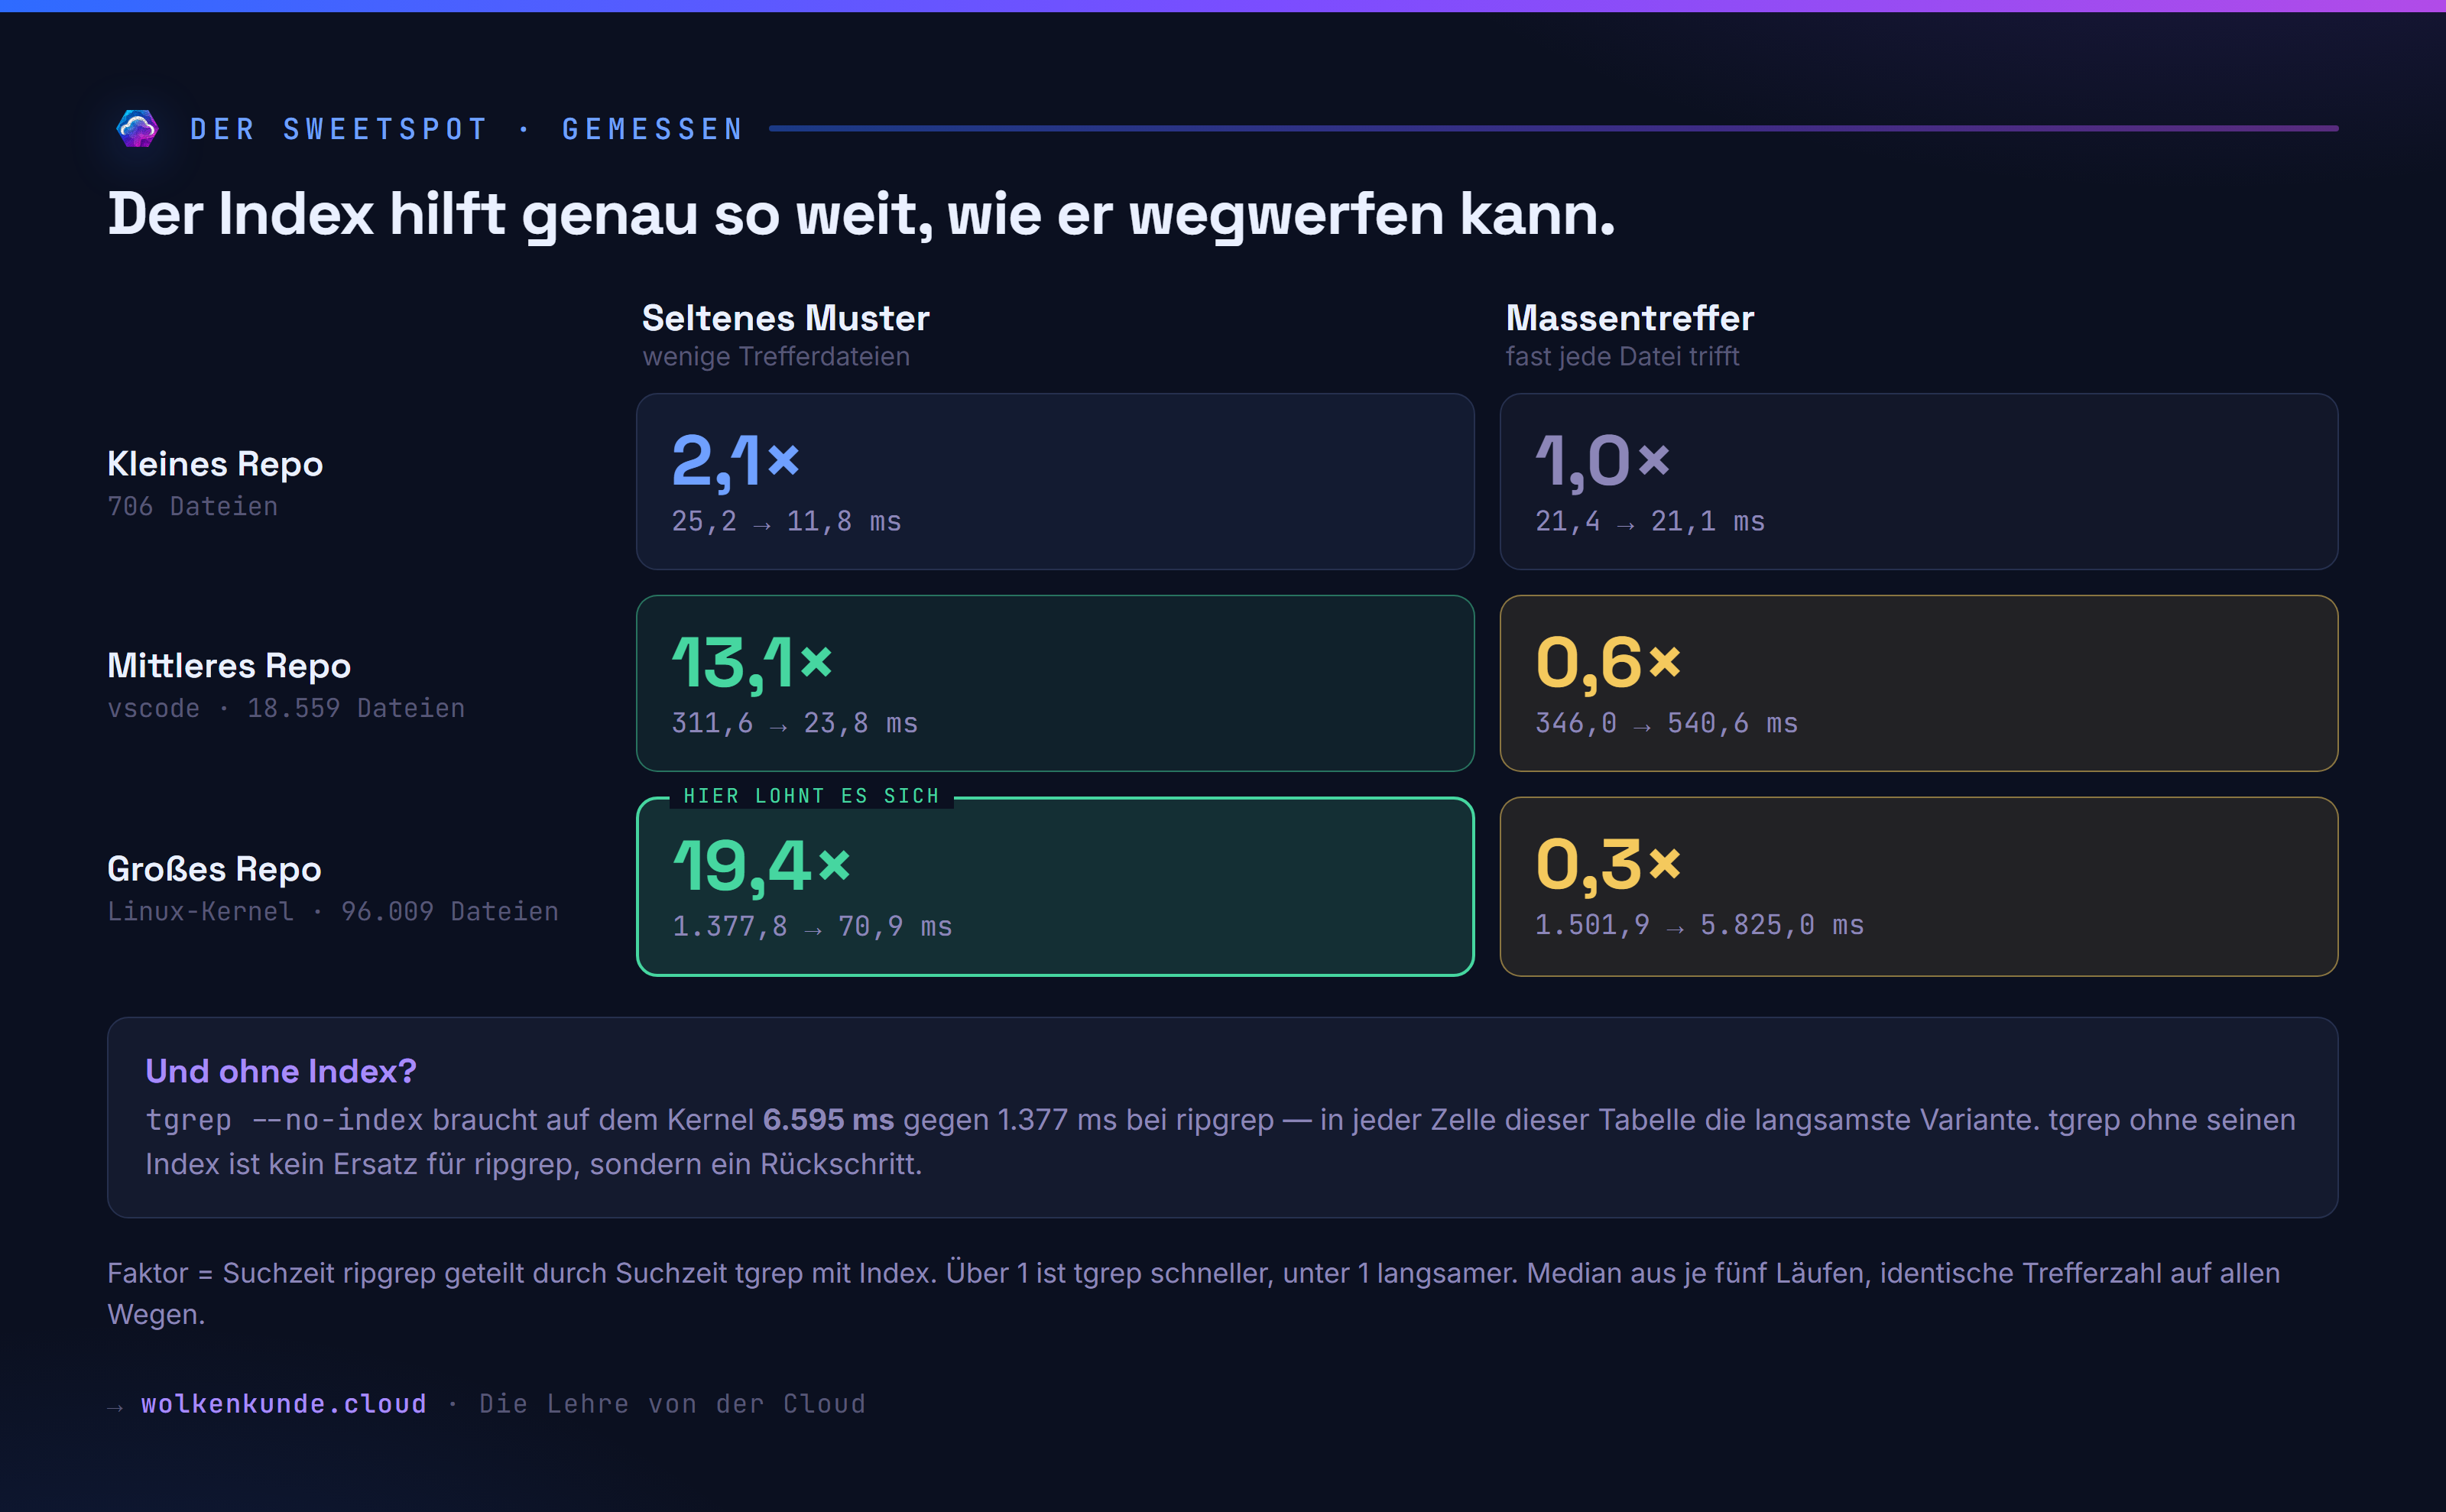
Der Sweetspot liegt unten links: großer Bestand, seltenes Muster. Dort bleiben von 96.009 Dateien eine Handvoll Kandidaten übrig, und genau daraus entsteht der Faktor 19.
Die rechte Spalte zeigt das Gegenteil. Bei static im Kernel trifft fast jede zweite Datei — es gibt nichts auszusortieren, und die Indexverwaltung kostet mehr, als sie spart. Der Index hilft genau in dem Maß, in dem er etwas wegwerfen kann. Beide Enden werden mit der Bestandsgröße deutlicher: Der Gewinn links wächst von 2,1 auf 19,4, der Verlust rechts von 1,0 auf 0,3.
Unter etwa tausend Dateien lohnt sich der Aufwand gar nicht. Diese Zeile wird später noch wichtig.
Im Detail für den Kernel:
| Muster | Trefferdateien | rg -n | tgrep -n | Faktor |
|---|---|---|---|---|
devm_kzalloc | 5.759 | 1.377,8 ms | 70,9 ms | 19,4× |
EXPORT_SYMBOL_GPL | 3.664 | 1.239,4 ms | 139,6 ms | 8,9× |
static | 43.443 | 1.501,9 ms | 5.825,0 ms | 0,3× |
Die Zahl aus der README nachgerechnet
Die Projektdokumentation nennt für den Linux-Kernel unter Windows 3.280 ms bei ripgrep gegen 94 ms bei tgrep, also Faktor 34,8. Wir messen auf demselben Bestand 1.377,8 gegen 70,9 ms, Faktor 19,4.
Die Richtung stimmt, der Faktor ist bei uns kleiner. Nicht weil tgrep langsamer wäre — 70,9 gegen ihre 94 ms —, sondern weil unser ripgrep mehr als doppelt so schnell läuft wie ihres. Wer solche Faktoren zitiert, zitiert immer auch die Maschine, auf der das Gegenstück lief.
Der eigentliche Test: 24 Agentenläufe
Die Messungen oben vergleichen Werkzeuge. Die Frage, auf die es ankommt, ist aber eine andere: Kostet dieselbe Aufgabe weniger, wenn der Agent eine schnellere Suche hat?
Aufbau: dieselbe Aufgabe im vscode-Repository — „In wie vielen Dateien kommt registerSingleton vor? Nenne die Zahl und die drei Dateien mit den meisten Vorkommen.” Modell Sonnet, acht Läufe je Variante, gezählt werden echte Tokens aus der Abrechnung, nicht geschätzte.
Entscheidend sind drei Varianten, nicht zwei. Sonst misst man nur, dass ein Agent mit Regel sparsamer arbeitet als einer ohne:
| Variante | Werkzeug | Regel im Systemprompt |
|---|---|---|
| ohne Regel | eingebaute Suche (ripgrep) | — |
| mit Regel | eingebaute Suche (ripgrep) | „erst Dateinamen oder Zählung, Zeileninhalte später” |
| mit Regel + tgrep | tgrep über die Shell | dieselbe, plus wie tgrep aufzurufen ist |
| Variante | Median | Mittel | Streumaß | Züge |
|---|---|---|---|---|
| ohne Regel | 322.108 | 339.528 | 16 % | 7 |
| mit Regel | 101.419 | 192.928 | 72 % | 2,5 |
| mit Regel + tgrep | 162.431 | 162.833 | 16 % | 3,5 |
Alle 24 Läufe lieferten die richtige Antwort.
Drei Befunde stehen darin, und sie widersprechen sich scheinbar:
Die Regel wirkt stärker als das Werkzeug. Ohne jede neue Software sinkt der Median von 322.108 auf 101.419 — Faktor 3,2. Das ist der größte Einzeleffekt der ganzen Messreihe, und er kommt allein daher, dass der Agent -c statt -n benutzt.
Die Regel allein ist aber ein Glücksspiel. Die acht Läufe teilen sich in zwei Gruppen: viermal 79.009 Tokens in zwei Zügen, viermal zwischen 124.000 und 420.718 in bis zu neun Zügen. Der Agent findet manchmal sofort den kurzen Weg und verzettelt sich manchmal.
Das Werkzeug macht es berechenbar. Alle acht Läufe mit tgrep liegen zwischen 136.648 und 191.035. Im Mittel ist das die günstigste Variante, im Median nicht.
Wer nur den Median vergleicht, erklärt die Regel zum Sieger. Wer nur den Mittelwert vergleicht, erklärt tgrep zum Sieger. Beides steht hier, weil beides stimmt. Zusammengefasst:
Die Regel senkt die Kosten. Das Werkzeug macht sie berechenbar.
Zwei Fallen, in die wir selbst getappt sind
Ein ruhender Index veraltet binnen Minuten
Unser erster Messlauf lief ohne Server. Das Ergebnis: tgrep --no-index fand 18 Trefferzeilen, tgrep mit Index nur 16. Der Index war zu diesem Zeitpunkt rund zehn Minuten alt und kannte zwei inzwischen angelegte Dateien nicht.
Keine Fehlermeldung, keine Warnung. Nur ein falsches Ergebnis.
Mit laufendem tgrep serve und aktivem File-Watcher stimmten alle Wege überein. Der Server ist keine Beschleunigung, sondern Voraussetzung für Korrektheit.
--no-ignore schaltet den Index ab
Unsere erste Messreihe im großen Bestand ergab, dass der Index überhaupt nichts bringt: mit und ohne Index exakt dieselbe Zeit, beide um 4.400 ms. Die Erklärung steht in der Statistikausgabe:
tgrep --no-ignore --stats -l -- "wk_resturlaub" .
# Brute-force search completed in 4457.6ms (65016 files): 18 matches

tgrep --stats -l -- "wk_resturlaub" .
# 18 matches (18 matched lines) in 4.2ms (via server)
Derselbe Index, dieselbe Suche, Faktor rund tausend. Mit --no-ignore fällt tgrep auf eine vollständige Suche zurück. Unsere erste Messreihe hatte den Index gemessen, indem sie ihn abschaltete — sie ist verworfen.
Merksatz: Ein Index deckt genau den Raum ab, für den er gebaut wurde. Wer beim Suchen die Sichtbarkeitsregeln ändert, bekommt keinen Fehler, sondern nur eine langsame Antwort.
--stats ist deshalb der erste Befehl, wenn eine Suche langsamer läuft als erwartet. Entweder steht dort „via server” — oder eben nicht.
Was du mitnimmst
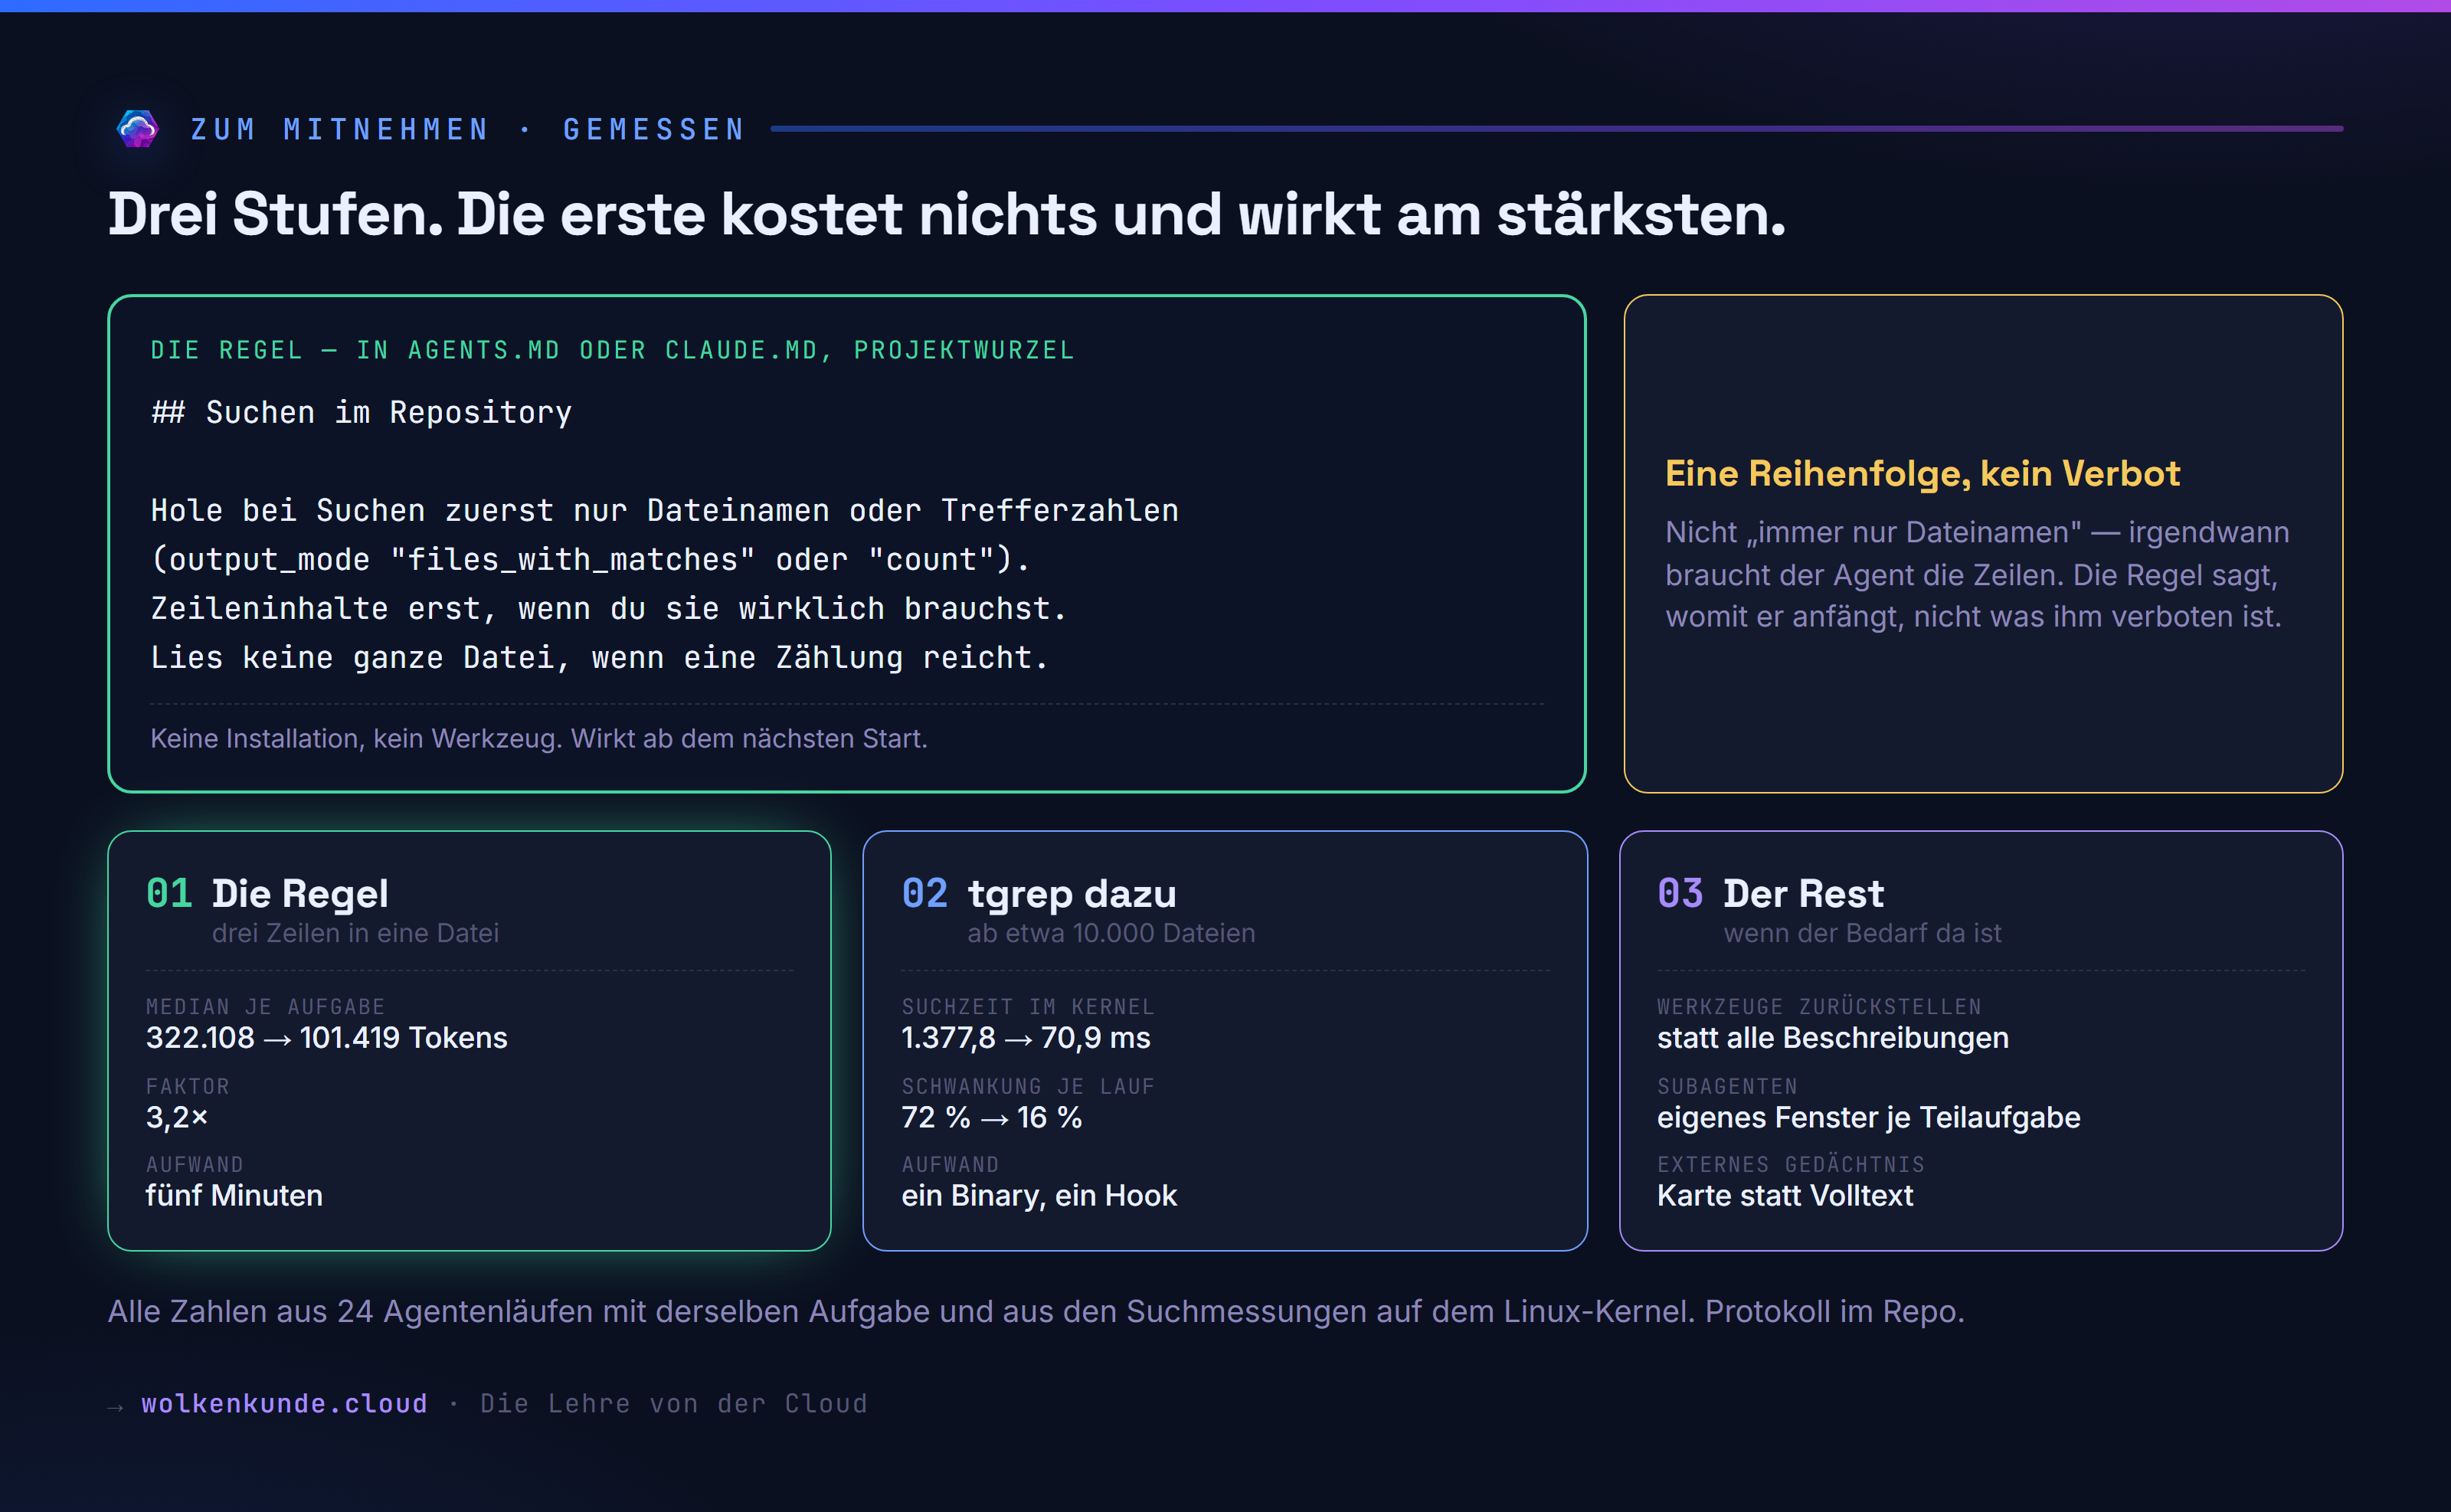
Stufe 1: die Regel
Das Wirksamste kostet nichts und braucht keine Installation. Drei Sätze in die Anweisungsdatei des Agenten:
## Suchen im Repository

Hole bei Suchen zuerst nur Dateinamen oder Trefferzahlen
(output_mode "files_with_matches" oder "count").
Zeileninhalte erst, wenn du sie wirklich brauchst.
Lies keine ganze Datei, wenn eine Zählung reicht.
Wichtig ist die Formulierung: Das ist eine Reihenfolge, kein Verbot. Nicht „immer nur Dateinamen” — irgendwann braucht der Agent die Zeilen. Die Regel sagt, womit er anfängt, nicht was ihm untersagt ist. Ein Verbot führt dazu, dass er dreimal nachfragt, statt einmal richtig zu lesen.
Wo die Datei hingehört. Der tool-übergreifende Standard heißt AGENTS.md, liegt in der Wurzel des Repositories und wird von über dreißig Agenten gelesen — Codex, Copilot, Cursor, Gemini CLI, Aider, Zed, Windsurf. Das Format wird bei der Agentic AI Foundation der Linux Foundation gepflegt. Es ist reines Markdown, ohne Pflichtfelder.
Claude Code liest nativ CLAUDE.md und inzwischen auch AGENTS.md. Wer eine einzige Quelle behalten will, schreibt in die CLAUDE.md als erste Zeile @AGENTS.md — dann wird die gemeinsame Datei mit hereingezogen. Eine Fassung für alle Projekte liegt unter ~/.claude/CLAUDE.md.
Cursor kennt zusätzlich .cursor/rules/, Copilot zusätzlich .github/copilot-instructions.md. Die werkzeugeigenen Dateien braucht nur, wer etwas festlegen will, das wirklich nur dieses eine Werkzeug betrifft.
Übrigens liefert tgrep selbst eine AGENTS.md mit, und darin steht genau diese Strategie: bei breiten Suchen zuerst -l, weil die Ausgabe kleiner ist. Microsoft weiß also, worauf es ankommt, und schreibt es in die Datei, die kaum jemand liest.
Stufe 2: tgrep dazu
Lohnt ab etwa zehntausend Dateien. Darunter ist der Gewinn klein, der Index aber trotzdem da.
Dazu gehört zwingend: der Server muss laufen. Am saubersten über einen Hook beim Sitzungsstart, der prüft, ob tgrep serve läuft, und ihn sonst hochfährt. Läuft er nicht, bekommt der Agent stillschweigend veraltete Antworten.
Und die Frage, wie man es dem Agenten beibringt: Eine Regel ist dafür die richtige Form, kein Skill. Ein Skill wird nur geladen, wenn der Agent ihn für einschlägig hält — eine Suchstrategie muss aber bei jedem Zug gelten, auch wenn er gar nicht merkt, dass er gerade sucht. Ein Skill ist die richtige Form nur für das Drumherum: Server starten, Indexstand prüfen, bei veraltetem Index neu bauen.
Stufe 3: der Rest
Wenn der Bedarf da ist: Werkzeugbeschreibungen zurückstellen statt alle mitführen, Subagenten für Teilaufgaben mit eigenem Fenster, ein externes Gedächtnis, das Karten statt Volltexte zurückgibt.
Grenzen
Ein paar Dinge, die diese Messung nicht zeigt.
Gemessen wurde eine Zählaufgabe. Ob der Befund auch für „finde und ändere das” oder „erkläre mir diesen Ablauf” gilt, ist offen. Gerade bei Aufgaben, die viel Kontext brauchen, könnte das Bild anders aussehen.
Alle Agentenläufe liefen mit einem Modell. Ein Modell, das besser plant, würde die Variante mit Regel stabiler machen und den Vorsprung von tgrep möglicherweise aufzehren.
Die Suchmessungen liefen auf einer Maschine, Windows 11 mit zwölf Threads. Auf schnelleren Platten fällt der Indexvorteil kleiner aus — das zeigt schon der Vergleich mit der README.
Und der wichtigste blinde Fleck: Dataverse-Entwicklung in großen Umgebungen. Unsere Bestände sind Content-Repos mit vielen kleinen Dateien. Ein entpackter Solution-Export sieht anders aus — wenige, dafür sehr große XML- und JSON-Dateien, dazu generierte Early-Bound-Klassen und mehrere Umgebungen nebeneinander. Das haben wir nicht gemessen. Wer dort arbeitet, sollte die Zahlen unten nicht ungeprüft auf sich übertragen.
Fazit: Für unseren Stack nehmen wir tgrep nicht
Das war nicht der Plan. Es war installiert, es war gemessen, und die Grafik für den Stack lag fertig da.
Dann haben wir unsere eigenen Repos gezählt. Das größte hat 389 Textdateien. Danach kommen 204, 163, 136. Kein einziges erreicht die Größenordnung, ab der ein Index wirkt.
In unserer eigenen Matrix ist das die oberste Zeile: Faktor 2,1. Aus 25 Millisekunden werden 12. Dafür einen Index bauen, der ein Fünftel der Codegröße belegt? Und einen Serverprozess betreiben, der laufen muss, damit die Antworten überhaupt stimmen? Das steht in keinem Verhältnis.
Was wir stattdessen übernehmen, ist die Regel. Drei Sätze in eine Textdatei. Sie hat in unserer Messung mehr gebracht als das Werkzeug: Eine Aufgabe, die vorher 322.108 Tokens kostete, kostet danach 101.419. Ein Drittel. Ohne Installation, ohne laufenden Prozess, wirksam ab dem nächsten Start.
Wofür diese Absage nicht gilt. Sie betrifft unseren Content-Stack: Blog, Studio, Reels und die Agenten-Pipeline dahinter. Wer Dataverse-Entwicklung in umfangreichen Kundenumgebungen macht, hat einen anderen Bestand vor sich, und die Antwort kann dort anders ausfallen. Das ist keine Höflichkeitsfloskel, sondern der ehrliche Zuschnitt unserer Messung — wir haben genau zwanzig kleine Repos geprüft und keine einzige große Umgebung.
Und wir wissen jetzt, wann wir tgrep holen. Sobald ein Bestand fünfstellig wird. Bei vscode war es dreizehnmal schneller, beim Linux-Kernel neunzehnmal. Der Tag kommt vielleicht — und dann steht die Anleitung dafür in diesem Artikel.
Die eine Sache, die man mitnehmen sollte, ist also nicht der Download. Es sind die drei Sätze.
Siehe auch
- Ein Gedächtnis, das bleibt: OpenViking als persönliches RAG — die dritte Achse bei uns im Detail
- „Welches Fenster meinst du?” — bts holt das richtige Browserfenster per CLI nach vorn — dasselbe Argument an einer anderen Stelle: ein schlankes Werkzeug schlägt ein mächtiges, wenn nur die Auswahl gebraucht wird
- Dein Flow ist das Tool — warum Werkzeuge für Agenten dorthin gehören, wo die Logik schon liegt
Quellen
- microsoft/tgrep — Repository, README und die mitgelieferte
AGENTS.md, MIT-Lizenz - BurntSushi/ripgrep — das Gegenstück in allen Messungen
- Unser vollständiges Messprotokoll mit allen Rohwerten, dem Läufer und den verworfenen Messreihen liegt im Repo unter
tools/token-messung/messprotokoll.md